Attribute Inference
La métrique Attribute Inference évalue le risque qu’un attaquant parvienne à déduire avec succès la valeur d’une variable cible, à partir d’un sous-ensemble d’attributs connus. On considère l'inférence comme réussie lorsque la modalité prédite est identique à la modalité réelle de la variable cible pour une donnée catégorielle, ou lorsque la valeur prédite est suffisamment proche de la valeur réelle pour une variable continue (~ 5%). Concrètement, chaque individu se voit attribuer la valeur de la variable cible correspondant à la donnée synthétique qui lui est la plus proche en termes de similarité. La performance de prédiction obtenue constitue la mesure du Attribute Inference. Cette métrique est particulièrement pertinente dans les scénarios d’attaque par inférence d’attributs, où des adversaires exploitent des données démographiques publiques ou faciles d’accès pour estimer des informations catégorielles sur des individus.
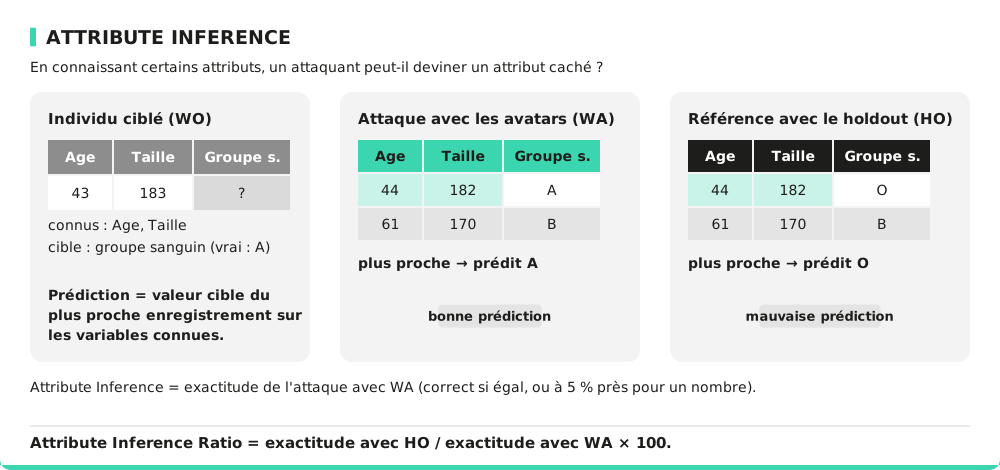
Corrélation inférée et inférence d’attribut dans les données synthétiques
Ce risque est plus large que l’inférence d’appartenance. Il concerne la capacité à déduire un attribut sensible sur une personne même en l’absence d’identifiant direct, d’appariement exact ou de lien explicite à un nom ou à un dossier source. L’attaque s’appuie sur les corrélations statistiques conservées dans les données synthétiques ou dans un modèle.
Le point essentiel est que les données synthétiques peuvent conserver des micro-corrélations qui sont réelles dans la population d’origine. Même sans correspondance brute un-à-un, un petit ensemble d’attributs connus peut suffire pour identifier une sous-population très étroite dans laquelle un attribut caché est très probable.
Exemple A : inférence d’un attribut financier à partir d’un jeu de données synthétique
- Contexte : une banque génère un jeu de données synthétiques reflétant le comportement financier de ses clients pour un hackathon d’analyse de risques.
- Connaissance de l’attaquant : l’attaquant sait que Valérie a 34 ans, vit à Cesson-Sévigné, est ingénieure et a deux enfants en bas âge.
- Attaque : l’attaquant filtre la base synthétique sur la combinaison : âge 30–35, ville Cesson-Sévigné, profession ingénieur, enfants = 2.
- Résultat : au sein de ce groupe très étroit, 98 % des lignes synthétiques présentent un niveau d’endettement élevé ou un schéma d’achat à crédit.
- Conclusion : la donnée synthétique a conservé une corrélation réelle propre à une sous-population très restreinte. L’attaquant infère quasi-certainement que Valérie est surendettée, alors même que ni son nom ni ses identifiants n’ont jamais été transmis.
Exemple B : inférence par prompting sur un modèle d’IA
- Contexte : une entreprise entraîne un LLM interne sur des comptes rendus d’entretien annuel pour aider les RH à rédiger des fiches de poste.
- Attaque : un employé saisit le prompt suivant : « Rédige une synthèse des retours managériaux pour un poste de chef de projet senior dans l’équipe Marketing, ayant rejoint l’entreprise en 2022 et ayant eu un arrêt maladie prolongé au printemps. »
- Résultat : le modèle génère du texte qui restitue des éléments très spécifiques de l’évaluation réelle d’une seule personne, révélant une situation médicale ou personnelle qui n’était pas destinée à être diffusée.
- Interprétation juridique et technique : la requête utilise des attributs secondaires pour isoler une personne très spécifique. Le modèle d’IA révèle ainsi un attribut sensible par complétion statistique.
C’est là le défi central pour les données synthétiques : si la sortie synthétique est trop fidèle à la réalité, elle conserve les micro-corrélations qui rendent possibles l’inférence d’appartenance et l’inférence d’attribut. Si elle est trop lissée, elle perd une partie de son utilité statistique pour la recherche ou l’IA. Une évaluation robuste de l’anonymat doit donc démontrer que de telles inférences ne sont plus réalistes dans le contexte d’usage, et non seulement qu’il n’existe pas de correspondance exacte ligne à ligne.
Le Attribute Inference Ratio est basé sur une référence : il compare l’inférence utilisant l’anonymisation (WO vs ses avatars WA) à l’inférence utilisant la variabilité naturelle des données réelles (WO vs une référence mise de côté HO).
- WO — moitié de travail originale : la partie des données originales qui est anonymisée.
- WA — avatars de travail : les avatars générés à partir de WO.
- HO — moitié de réserve originale : un second échantillon de données réelles, laissé intact, utilisé uniquement comme référence.
Sur les jeux de données suffisamment grands (par défaut ≥ 500 lignes), un holdout réel est mis de côté avant l’anonymisation ; sur les plus petits, un holdout approximatif est obtenu en divisant aléatoirement les données au moment du calcul des métriques. Voir la section « Évaluation avec une référence de holdout » du rapport d'évaluation technique.
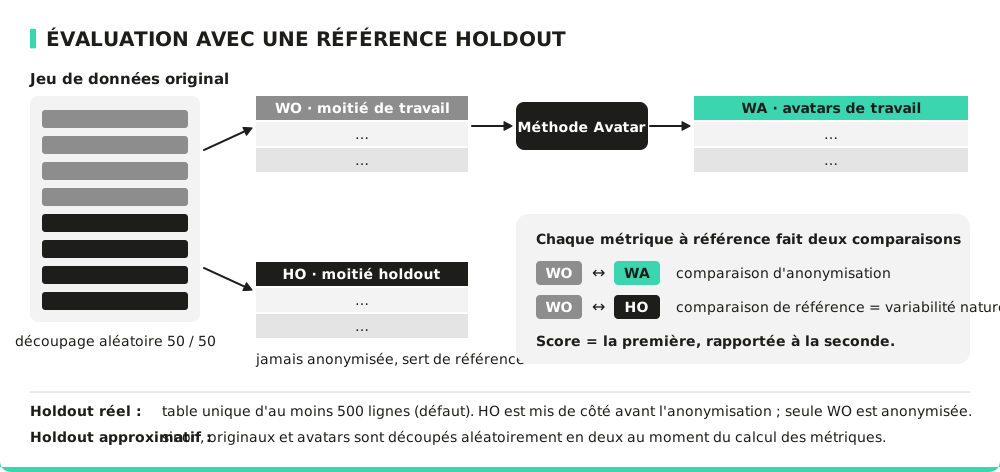
Stratégie de comparaison (Holdout)
Pour faciliter l’interprétation, cette métrique est divisée en deux sous-métriques distinctes :
- Attribute Inference : évalue le risque d’inférence pour une variable cible telle que décrit ci-dessus.
- Attribute Inference Ratio : comparaison de la performance d’inférence obtenue avec les avatars contre celle d’un modèle de référence.
Pour réaliser cette comparaison, nous réalisons les étapes suivantes :
- Obtention de la moitié de travail WO et d’une moitié de réserve HO disjointe à partir des données réelles (holdout réel ou approximatif — voir la note ci-dessus).
- Utilisation des avatars de travail WA, générés à partir de WO.
- Calcul de la métrique Attribute Inference sur l’ensemble WO en utilisant WA comme base d’attaque.
- Calcul de la métrique Attribute Inference sur l’ensemble WO en utilisant HO comme base d’attaque.
- Calcul du ratio entre les deux performances obtenues.
Interprétation de la métrique
La métrique Attribute Inference s’exprime sous la forme de la précision de l’attaquant (en %) :
- une valeur de 0 % signifie aucun succès pour l’attaquant ;
- des valeurs plus élevées indiquent une meilleure précision de l’attaquant, et donc un risque d’inférence plus élevé.
Contrairement aux autres métriques de confidentialité, plus cette métrique est faible, plus la protection de la vie privée est forte.
La métrique Attribute Inference Ratio s’interprète de la manière suivante :
- une valeur proche de 100 % indique que la performance d’inférence avec les avatars est similaire à celle obtenue avec les données réelles. Le processus d'anonymisation n'augmente pas le risque d'inférence.
- une valeur inférieure à 100 % signifie que l’utilisation des avatars augmente la capacité de l’attaquant à inférer correctement la variable cible.
Exemple concret
Si la valeur de la métrique Attribute Inference est de 20 %, cela signifie que les attaquants prédisent correctement la cible pour 20 % des individus, ce qui représente un risque faible d’inférence réussie.
À l’inverse, une valeur de 90 % signifie une précision de 90 % pour les attaquants — ce qui représente un risque élevé et nécessite des ajustements pour améliorer la protection des données.
Si la valeur de la métrique Attribute Inference Ratio est de 50 %, cela indique que l’utilisation des avatars double la capacité des attaquants à inférer correctement la variable cible par rapport à l’utilisation des données réelles.
Spécificité de la métrique
Ces métriques sont essentielles pour évaluer la capacité de la méthode Avatar à protéger du risque d'inférence.
Pour plus d'interprétabilité, il est important de considérer à la fois la métrique Attribute Inference et la métrique Attribute Inference Ratio.
En effet l'Attribute Inference Ratio peut indiquer que les avatars augmentent fortement la capacité d'inférence des attaquants, mais si la métrique Attribute Inference reste faible, le risque global d'inférence peut rester faible.
Formule
Les variables connues sont projetées (analyse factorielle ajustée sur , composantes). Pour chaque original de travail , la prédiction est la valeur cible de son plus proche voisin dans la base d'attaque (, ou pour la référence). Une prédiction est correcte lorsque
(pour , la tolérance vaut fois la moyenne des cibles non nulles en valeur absolue). Puis
Le ratio n'est pas défini lorsque .
Comment améliorer cette métrique ?
Pour améliorer ces métriques, commencez par identifier les variables démographiques les plus prédictives de la variable cible.
Ensuite, analysez si des groupes d’individus partageant les mêmes attributs démographiques clés ont tendance à présenter des valeurs similaires pour la variable la variable cible.
Si de tels regroupements (clusters) existent, il est recommandé de fixer le paramètre k (le nombre de voisins pris en compte lors de la génération des données synthétiques) à une valeur supérieure à la taille de ces clusters.
Cela augmente la variabilité entre les individus ayant des valeurs cible similaires, réduit le risque d’inférence et diminue la précision de l’attaquant mesurée par la métrique, contribuant ainsi à renforcer la protection de la vie privée.