Pairwise Correlation Difference
La Pairwise Correlation Difference (PCD) quantifie la différence globale dans la structure des corrélations entre le jeu de données original et le jeu transformé. Elle est calculée comme la norme matricielle de la différence entre les matrices de corrélation de Pearson des deux jeux de données.
Mathématiquement :
où et sont respectivement les matrices de corrélation du jeu de données original et transformé.
Une valeur faible de PCD indique que la structure des corrélations dans le jeu transformé est proche de celle de l’original.
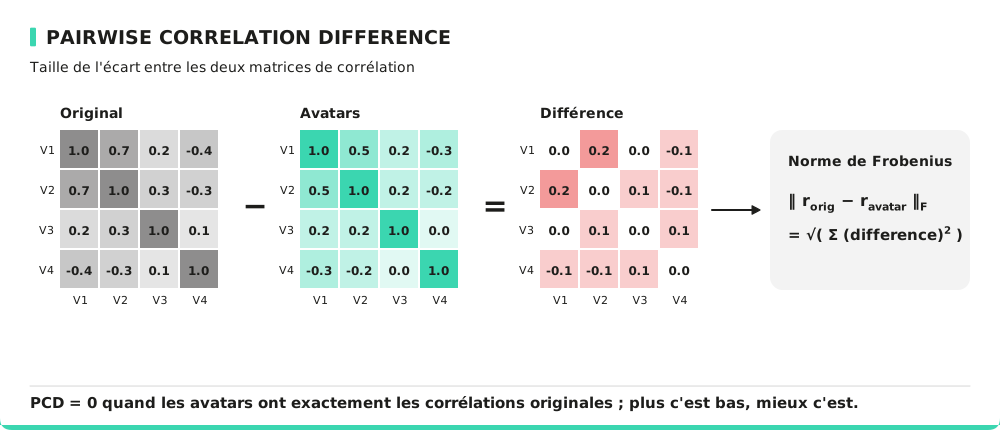
Interprétation de la Pairwise Correlation Difference
- PCD = 0 : Le jeu de données transformé a des corrélations identiques à l’original.
- PCD faible : Le jeu transformé conserve la plupart des structures de corrélation.
- PCD élevée : Les corrélations entre variables ont changé significativement, ce qui peut nuire à la fiabilité des analyses.
Supposons un jeu de données contenant âge, revenu et niveau d’éducation. Si dans l’original, les corrélations sont élevées (par exemple âge vs revenu = 0,65, éducation vs revenu = 0,50), mais que dans le jeu transformé elles chutent (0,30 et 0,20 respectivement), la métrique PCD indiquera une perte importante de la structure de corrélation.
Spécificités du métrique
Avantages :
- Capture la différence globale dans la structure de corrélation, pas seulement entre paires individuelles.
- Facile à interpréter : des valeurs plus faibles signifient une meilleure conservation des corrélations.
- Utile pour l’analyse de jeux de données avec plusieurs variables corrélées.
Limites :
- Sensible aux transformations qui affectent plusieurs variables simultanément.
- Ne capture pas les relations non linéaires (basée uniquement sur la corrélation de Pearson).
- Ne prend pas en compte les relations entre variables catégorielles.
Formule
Avec et les matrices de corrélation de Pearson des données originales et avatar (les écarts manquants sont mis à 0) :
Comment améliorer ce métrique ?
Pour réduire la Pairwise Correlation Difference, vous pouvez ajuster le paramètre k afin de mieux aligner les distributions.
Vous pouvez également appliquer des projections pondérées en accordant plus d’importance aux variables critiques lors de la génération des données.
Enfin, un traitement ciblé basé sur les caractéristiques des variables peut améliorer la conservation des relations entre variables.