Hellinger Mean
La Hellinger Mean compare l'écart entre les distributions des avatars et une moitié mise de côté du jeu de données original, à l'écart entre les deux moitiés du jeu de données original. Pour des raisons d'interprétabilité, elle utilise la variabilité naturelle des données comme référence.
Pour les deux comparaisons, elle calcule la Hellinger distance variable par variable, où la Hellinger distance mesure la divergence entre deux distributions de probabilité (0 = identiques, 1 = complètement différentes).
Cette métrique s'applique aux variables catégorielles et continues. Pour les variables continues, la Hellinger distance est estimée via un histogramme, tandis que pour les variables catégorielles, elle est calculée directement à partir des fréquences observées.
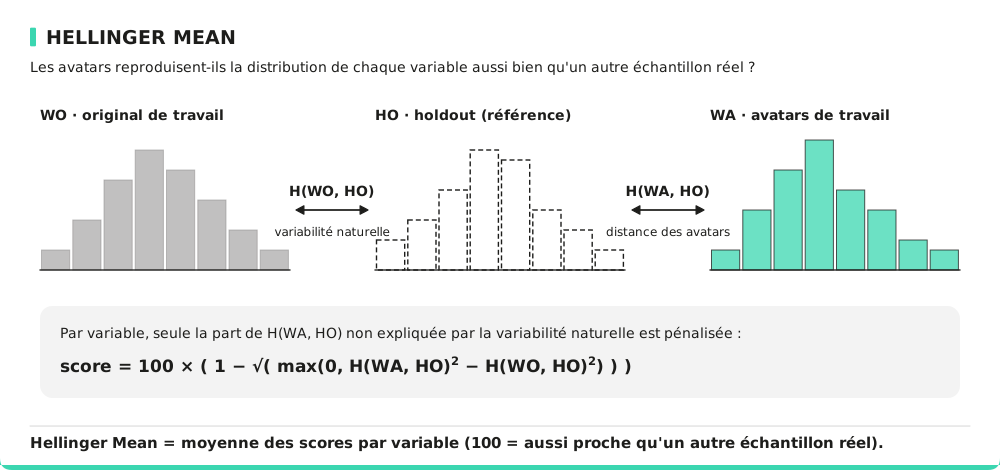
Cette métrique est basée sur une référence : elle compare l’anonymisation (WO vs ses avatars WA) à la variabilité naturelle des données réelles (WO vs une référence mise de côté HO).
- WO — moitié de travail originale : la partie des données originales qui est anonymisée.
- WA — avatars de travail : les avatars générés à partir de WO.
- HO — moitié de réserve originale : un second échantillon de données réelles, laissé intact, utilisé uniquement comme référence.
Sur les jeux de données suffisamment grands (par défaut ≥ 500 lignes), un holdout réel est mis de côté avant l’anonymisation ; sur les plus petits, un holdout approximatif est obtenu en divisant aléatoirement les données au moment du calcul des métriques. Voir la section « Évaluation avec une référence de holdout » du rapport d'évaluation technique.
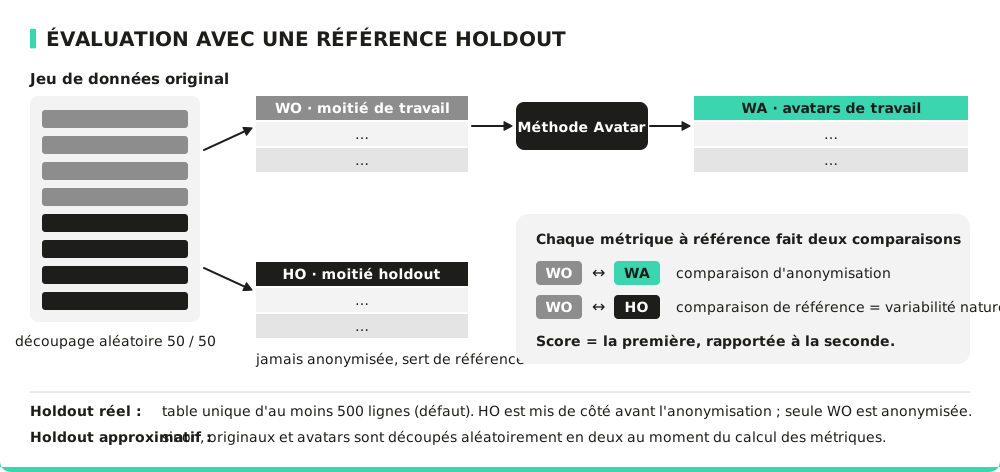
Stratégie de comparaison (Holdout)
Pour calculer le score final retourné à l'utilisateur, nous effectuons les étapes suivantes :
- Obtention de la moitié de travail WO et d’une moitié de réserve HO disjointe à partir des données réelles (holdout réel ou approximatif — voir la note ci-dessus).
- Utilisation des avatars de travail WA, générés à partir de WO.
- Pour chaque variable, calculer la Hellinger distance entre WO et HO (distance de référence : la variabilité naturelle).
- Pour chaque variable, calculer la Hellinger distance entre WA et HO (distance avatar). Les deux distances sont mesurées par rapport à HO, car les avatars sont générés à partir de WO et héritent de son erreur d'échantillonnage.
- Noter chaque variable
100 × (1 − √max(0, distance_avatar² − distance_référence²)), puis faire la moyenne des scores sur les variables (voir la formule ci-dessous).
Interprétation de la Hellinger Mean
- Plus la valeur est proche de 100, plus les avatars préservent la variabilité naturelle du jeu de données.
- Des valeurs proches de 100 indiquent que les avatars diffèrent des données originales autant que les données originales diffèrent entre elles — bonne rétention du signal.
- Des valeurs inférieures à 100 indiquent que les distributions des avatars s'écartent davantage des distributions originales que ne le suggère la variabilité naturelle — dégradation du signal.
Considérons une variable dont la distance de référence (entre les deux moitiés des données originales) est 0,05 et la distance avatar est 0,10. La part non expliquée par la variabilité naturelle vaut √(0,10² − 0,05²) ≈ 0,087 : la variable obtient 100 × (1 − 0,087) ≈ 91. Une distance avatar égale à la distance de référence obtiendrait 100.
Spécificités de la métrique
Avantages :
- Capture la forme globale des distributions pour les variables continues et catégorielles.
- Utilise la variabilité naturelle du jeu de données comme référence, rendant le résultat plus interprétable qu'une distance brute.
- Fournit un score borné entre 0 et 100.
Limites :
- Sensible au choix du découpage en classes lors de l'estimation des distributions pour les variables continues.
- Peut ne pas capturer pleinement les différences locales entre distributions.
- Impactée par les variations de taille d'échantillon entre les jeux de données.
Formule
Pour une variable de fonctions de masse et sur les mêmes classes :
Pour chaque variable , la distance des avatars est mesurée par rapport au holdout, et seule la part non expliquée par la variabilité naturelle est pénalisée :
Les variables numériques sont découpées sur une grille commune de classes : de largeur égale, ou d'effectif égal quand les valeurs sont nettement asymétriques. Les variables catégorielles utilisent leurs fréquences observées.
Comment améliorer cette métrique ?
Pour améliorer le score de la Hellinger Mean, vous pouvez ajuster le paramètre k afin d'aligner plus précisément les distributions. Vous pouvez également appliquer des projections pondérées en donnant plus d'importance aux variables critiques lors de la génération de données. Enfin, utilisez un traitement ciblé en appliquant des transformations adaptées aux caractéristiques des variables.