Kolmogorov-Smirnov
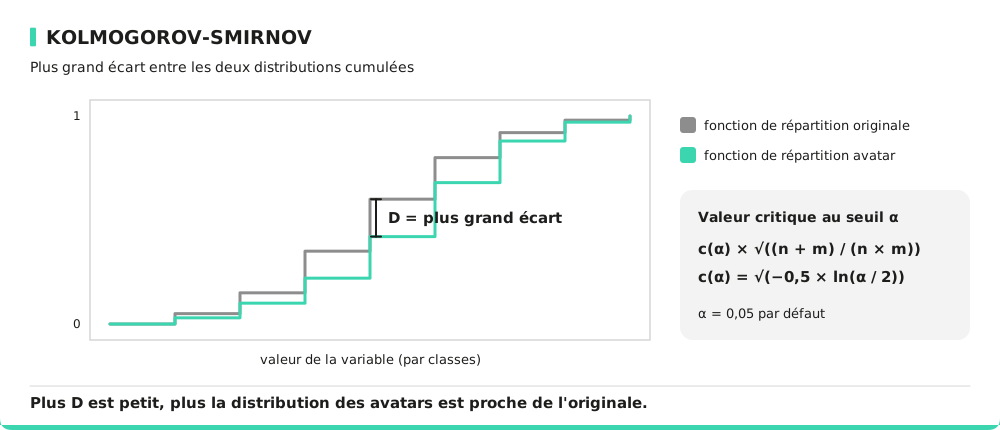
Le test Kolmogorov-Smirnov (KS) est un test statistique non paramétrique qui compare deux fonctions de distribution cumulée empirique (CDF empiriques) afin de déterminer si elles proviennent de la même distribution. Il calcule la différence absolue maximale entre les CDF empiriques du jeu de données original et du jeu synthétique.
Le test KS est particulièrement utile pour les jeux de données de petite taille. Dans l'implémentation, les fonctions de répartition sont calculées sur les mêmes classes que les autres métriques univariées (voir la formule ci-dessous).
Interprétation du test Kolmogorov-Smirnov
Le test KS fournit une p-valeur qui indique si l’hypothèse nulle (les distributions sont identiques) peut être rejetée :
- p > 0,05 : Pas de différence significative entre les distributions.
- p < 0,05 : Suggère que les données synthétiques diffèrent de la distribution originale.
Note : Le risque alpha dans un test statistique correspond à la probabilité de rejeter à tort l’hypothèse nulle alors qu’elle est vraie. En termes simples, c’est la probabilité de détecter un effet ou une différence qui n’existe pas réellement. Par exemple, dans un essai médical, un risque alpha de 5 % signifie qu’il y a 5 % de chances de conclure à tort qu’un traitement est efficace alors qu’il ne l’est pas. Réduire alpha diminue ce risque mais augmente la probabilité de ne pas détecter un effet réel.
Une statistique KS plus faible implique une meilleure similarité.
Considérons un jeu de données avec une variable montant des transactions clients. Le test KS permet de vérifier si les données synthétiques conservent la même distribution cumulée. Si le jeu synthétique sous-estime les transactions de forte valeur, la statistique KS sera plus élevée, indiquant un écart par rapport aux données originales.
Spécificités de la métrique
Avantages :
- Fournit un seuil de décision statistique, utile pour les petits jeux de données.
- Peut détecter des différences subtiles dans les distributions cumulées.
Limites :
- Plus sensible aux variations dans les petits échantillons.
- Moins intuitive que des métriques bornées comme la distance de Hellinger.
Formule
Avec et les distributions par classes de la variable dans les données originales ( valeurs) et avatar ( valeurs), et , leurs sommes cumulées :
Les distributions sont jugées différentes au seuil (0,05 par défaut) lorsque . Les variables numériques sont découpées sur une grille commune de classes : de largeur égale, ou d'effectif égal quand les valeurs sont nettement asymétriques. Les variables catégorielles utilisent leurs fréquences observées.
Comment améliorer cette métrique ?
Pour réduire la statistique KS du test Kolmogorov-Smirnov et améliorer la similarité, vous pouvez ajuster le paramètre k afin d’aligner plus précisément les distributions. Vous pouvez également appliquer des projections pondérées en donnant plus d’importance aux variables critiques lors de la génération de données. Enfin, utilisez un traitement ciblé en appliquant des transformations adaptées aux caractéristiques des variables.