Exécutions sur base de données (Bêta)
Les exécutions sur base de données sont actuellement en bêta. L'API et le comportement peuvent évoluer dans les prochaines versions. Essayez d'abord une exécution sur une base de données où une erreur est sans conséquence, par exemple l'une des bases de démonstration.
Une exécution sur base de données lit une base de données, l'anonymise avec la méthode Avatar et écrit le résultat dans une autre base de données. Vous obtenez une copie de travail d'une base de production : les mêmes tables, les mêmes jointures et à peu près le même nombre de lignes, sans aucun individu réel.
Utilisez-la pour donner à une équipe de test, de développement ou d'analyse une base de données qu'elle peut interroger comme la vraie, sans passer par un export CSV.
Les exécutions sur base de données nécessitent le connecteur de bases de données, un composant optionnel de la plateforme. Il est activé sur le SaaS Octopize. Sur une installation auto-hébergée, il est désactivé par défaut : demandez à votre administrateur de l'activer. Toutes les autres fonctionnalités fonctionnent sans lui.
Fonctionnement d'une exécution sur base de données
Une exécution sur base de données comporte quatre étapes. La deuxième étape est obligatoire.
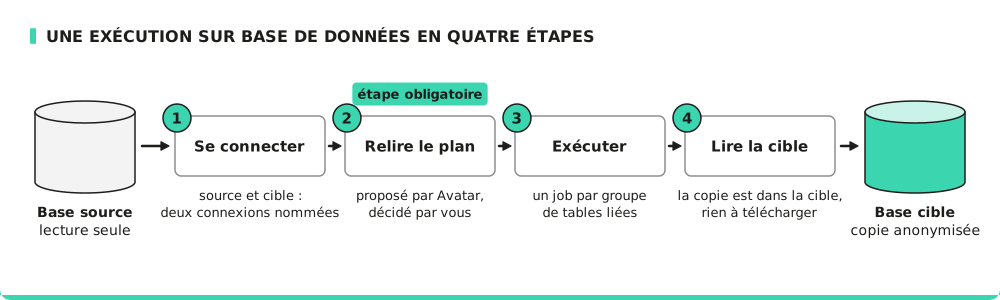
- Se connecter : vous choisissez une source et une cible. Chacune est une connexion nommée conservée par Avatar. Un job porte le nom d'une connexion, jamais son mot de passe.
- Relire le plan : Avatar lit la structure de la source (découverte du schéma) et propose un traitement pour chaque table et chaque variable (classification). Vous lisez la proposition, vous la corrigez et vous la confirmez. Une exécution qui contient une proposition non confirmée est refusée au démarrage.
- Exécuter : Avatar copie la base de données. Les tables liées par des clés étrangères sont anonymisées ensemble, dans un seul job. Chaque groupe de tables liées est un job distinct.
- Lire la cible : le résultat est la base de données cible elle-même. Il n'y a aucun fichier à télécharger. Chaque job produit aussi les métriques de confidentialité et d'utilité et les rapports habituels.
Vous pouvez tout faire depuis le client web ou depuis le client Python.
Ce qui arrive aux données
Chaque table reçoit un traitement (copy, pseudonymize, anonymize, purge ou ignore) et chaque variable une action (anonymize, pseudonymize, freeze ou drop). Avatar les propose à partir des noms et du contenu des variables ; vous confirmez ou corrigez la proposition. Les clés sont réattribuées pour que chaque jointure fonctionne toujours, et une entité partagée donne à un même individu la même fausse identité dans chaque table.
Les règles derrière ces choix, et ce qu'elles impliquent pour la vie privée, sont décrites dans Anonymisation de bases de données. Lisez-la avant votre première exécution : en particulier, une variable gelée conserve ses vraies valeurs dans la copie.
Exigences pour la cible
- La cible est une base de données différente de la source. Une exécution refuse une cible qui est la même connexion que la source, mais deux connexions différentes qui pointent vers la même base de données ne sont pas détectées : vérifiez-le vous-même.
- La cible utilise le même moteur que la source : PostgreSQL vers PostgreSQL, MySQL vers MySQL. Avatar ne traduit pas un schéma entre deux moteurs de base de données.
- La cible possède déjà le schéma : chaque table dans laquelle l'exécution écrit, y compris
les tables que vous purgez, doit exister dans la cible. Une exécution ne crée pas de tables
dans une base de données qu'elle atteint par le connecteur de bases de données, et refuse de
démarrer quand une table manque, en la nommant. Créez d'abord le schéma, par exemple avec
pg_dump --schema-onlyrestauré dans la cible. Les cibles de démonstration possèdent déjà le schéma de leur source de démonstration. - Une table cible qui contient déjà des lignes est refusée, sauf si vous demandez à l'exécution de vider d'abord la cible (Vider cette cible avant d'écrire dans le client web). Le client Python ne propose pas encore cette option.
Toutes les vérifications ont lieu avant l'écriture de la première ligne. Les messages d'erreur nomment des tables et des variables, jamais des valeurs.
Comment la cible est vidée
Quand vous demandez à vider la cible, l'exécution supprime les lignes des tables dans lesquelles
elle écrit, et seulement de celles-ci. Elle ne supprime jamais une table. Les lignes sont
supprimées avec DELETE, les enfants avant les parents, en une seule transaction. ClickHouse
utilise TRUNCATE TABLE sur chaque table, et MongoDB supprime les documents de chaque
collection.
L'exécution refuse de vider la cible quand une table dans laquelle elle n'écrit pas a une clé
étrangère avec une action ON DELETE (comme CASCADE ou SET NULL) vers une table dans
laquelle elle écrit : supprimer les lignes modifierait une table à laquelle l'exécution n'a pas
été chargée de toucher.
Crédits
Une exécution sur base de données est facturée par table : chaque groupe coûte 1 crédit par table qu'il anonymise ou pseudonymise. Les tables copiées, purgées ou ignorées sont gratuites. La découverte du schéma, l'extraction des lignes et la résolution des entités partagées sont gratuites. Voir Crédits.
Pour aller plus loin
- Anonymisation de bases de données : ce qui arrive à chaque table, à chaque variable et à chaque clé.
- Connexions aux bases de données : ce à quoi vous pouvez vous connecter, et comment ajouter une connexion.
- Lancer une copie de base de données dans le client web
- Lancer une copie de base de données avec le client Python
- Pour les administrateurs : activer le connecteur de bases de données sur une installation Kubernetes auto-hébergée.