Anonymisation de bases de données (Bêta)
L'anonymisation de bases de données est actuellement en bêta. L'API et le comportement peuvent évoluer dans les prochaines versions. Essayez-la d'abord sur une base de données où une erreur est sans conséquence, par exemple l'une des bases de démonstration.
Avatar peut lire une base de données, l'anonymiser et écrire le résultat dans une autre base de données. Le résultat est une copie de travail d'une base de production : les mêmes tables, les mêmes jointures et à peu près le même nombre de lignes, sans aucun individu réel.
Cette page explique ce qu'Avatar fait de chaque table et de chaque variable de la base de données. Elle s'appuie sur la méthode pour les bases relationnelles, qui anonymise ensemble les tables liées, et sur la pseudonymisation, qui remplace les identifiants directs. Pour lancer une exécution, voir Exécutions sur base de données dans le guide utilisateur.
Ce qui arrive à chaque table
Chaque table reçoit un traitement :
| Traitement | La table dans la cible |
|---|---|
| copy | les mêmes lignes, inchangées. À utiliser pour une table de référence (lookup). |
| pseudonymize | les mêmes lignes. Les valeurs personnelles sont remplacées par de fausses valeurs. |
| anonymize | des lignes synthétiques, générées avec la méthode Avatar. |
| purge | la table est présente, sans aucune ligne. À utiliser pour un journal d'audit. |
| ignore | la table est absente de la cible. |
purge et ignore sont volontairement différents. Après purge, une application peut interroger la table et la trouver vide. Après ignore, la table n'existe pas.
Avatar ne propose jamais purge ni ignore : vous seul savez qu'un journal d'audit doit être vidé.
Ce qui arrive à chaque variable
Le client web et le client Python appellent une variable une colonne, comme le font les bases de données. Dans une table, chaque variable reçoit une action :
| Action | Les valeurs dans la cible |
|---|---|
| anonymize | des valeurs synthétiques, tirées de la distribution de la variable. |
| pseudonymize | de fausses valeurs de même nature (un e-mail pour un e-mail), appliquées de façon cohérente. |
| freeze | les valeurs d'origine, inchangées. |
| drop | la variable est absente de la cible. |
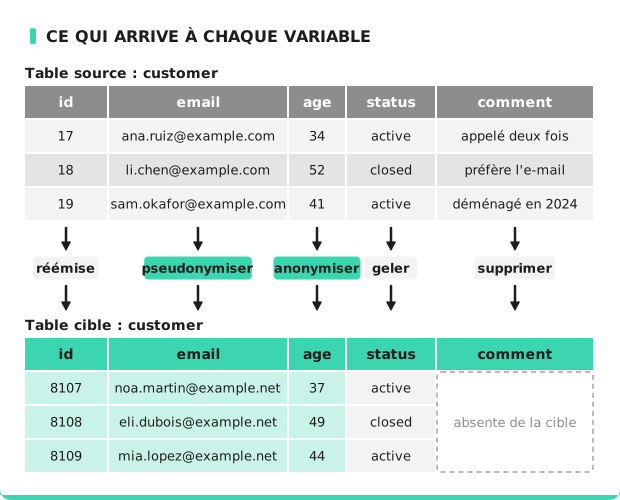
Pour choisir, demandez-vous ce dont les utilisateurs de la copie ont besoin dans cette variable :
- Une valeur qui doit paraître réelle mais n'appartenir à aucun individu, comme un nom ou un e-mail : pseudonymize.
- Un nombre ou une catégorie dont la distribution compte, comme un montant ou un âge : anonymize.
- Un code sur lequel une application filtre, comme une devise ou un statut, et qui n'identifie aucun individu : freeze.
- Une valeur dont aucun utilisateur de la copie n'a besoin, comme un commentaire en texte libre : drop.
L'anonymisation rééchantillonne : elle tire des valeurs de la distribution réelle. Une valeur réelle peut apparaître dans la copie, rattachée à un autre individu. C'est correct pour un montant, et incorrect pour une adresse e-mail. Les identifiants directs doivent être pseudonymisés : voir Pseudonymisation.
Une variable gelée conserve ses valeurs d'origine dans la copie. Ne gelez qu'une variable qui n'identifie aucun individu, seule ou combinée à d'autres variables. Une variable gelée qui identifie quelqu'un, ou qui permet d'isoler un individu avec d'autres variables, fait fuir des données personnelles dans la copie. Voir les métriques de confidentialité pour les risques d'individualisation, de corrélation et d'inférence.
Une variable binaire, comme une photo ou un document numérisé, est vidée dans la copie par défaut.
Ce qu'Avatar propose
La classification lit d'abord le nom de chaque variable. Une variable appelée email contient un
e-mail. Quand aucune règle ne s'applique, un modèle fait une estimation, avec un niveau de
confiance. La proposition suit trois règles :
| Ce qu'Avatar a trouvé | Ce qu'il propose |
|---|---|
| une variable classée comme personnelle | pseudonymize |
| une clé primaire ou une clé étrangère | rien : l'exécution s'en charge |
| toute autre variable | anonymize |
Une table dont aucune variable n'est reconnue est proposée pour l'anonymisation, pas pour la copie. Une table peut identifier des individus par une combinaison de variables qu'aucune règle ne détecte.
Vous n'avez à confirmer que les variables sur lesquelles le classifieur a émis un avis. Rejeter une proposition est aussi une décision, et Avatar l'enregistre comme telle.
Clés et jointures
Les clés primaires et les clés étrangères ne reçoivent aucune action de variable. L'exécution réattribue chaque clé primaire : elle remplace chaque clé par une autre valeur et modifie chaque clé étrangère qui pointe vers elle. Toutes les jointures fonctionnent toujours dans la cible.
La conséquence : les valeurs des clés changent. Si une application ou une donnée de test
interroge WHERE country_code = 'FR' et que country_code est une clé, elle ne trouvera pas la
ligne. Conserver la valeur d'une clé n'est pas encore possible. Geler une clé est refusé, car une
clé étrangère gelée dont le parent a changé est une jointure cassée qui passe inaperçue.
Séquences
Si une variable tire ses valeurs d'une séquence (par exemple une colonne PostgreSQL SERIAL), la
séquence de la cible ne connaît pas les lignes copiées. Demandez à l'exécution de continuer la
séquence après les lignes copiées, sinon la première ligne insérée par votre application entre
en collision avec une ligne copiée. Vous pouvez aussi redémarrer la séquence, ou la faire
commencer à la valeur de votre choix.
Le client Python et la configuration YAML règlent les séquences. Le client web ne les règle pas encore.
Un individu, une identité : les entités partagées
L'e-mail d'un client peut se trouver dans la table customer et dans la table invoice. Si les
deux variables sont pseudonymisées séparément, le même individu reçoit deux identités, et les
jointures qu'une base de test doit exercer sont cassées.
Une entité partagée indique que plusieurs tables décrivent la même chose (un individu, un produit, un site) et nomme la variable qui l'identifie. L'exécution la remplace une seule fois, et utilise le même remplacement dans chaque table et dans chaque job de l'exécution.
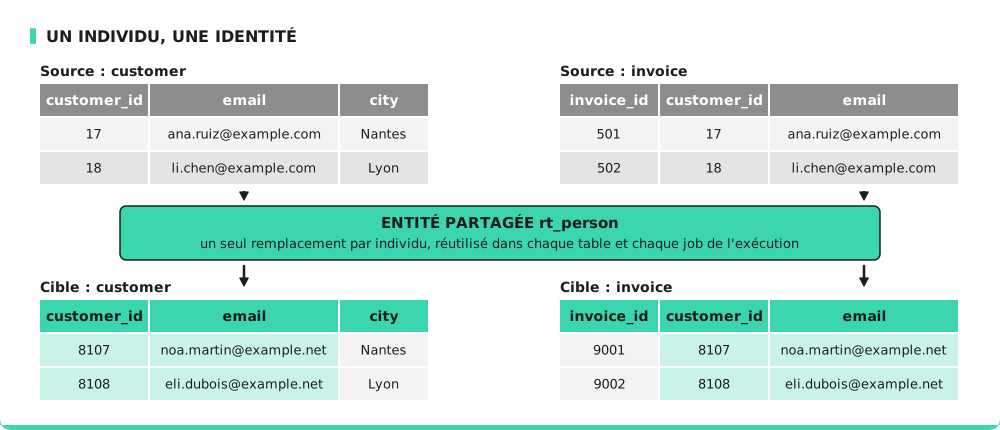
Le client web appelle une entité partagée une table de référence.
Une entité partagée peut aussi couvrir plusieurs bases de données : par exemple, un CRM et un système de facturation qui décrivent les mêmes clients. Traitez-les ensemble, dans une seule exécution, pour qu'un client reçoive la même fausse identité dans les deux copies.
Un remplacement dépend de l'ensemble complet des entités que l'exécution collecte. Si vous ajoutez plus tard une troisième base de données à l'exécution, toutes les fausses identités changent, dans toutes les copies. Un ensemble de copies rafraîchi avec une source supplémentaire ne partage aucun individu avec le précédent.
Groupes de tables
Les tables liées par des clés étrangères doivent être anonymisées ensemble, comme pour toute base relationnelle. Les tables non liées sont des jeux de données distincts qui se trouvent dans la même base. Avatar trouve ces groupes et lance un job par groupe. Vous n'avez pas à l'organiser vous-même.
Le statut, l'échec et la relance se gèrent par groupe. Un groupe en échec n'annule pas le travail des autres groupes. Tous les jobs d'une exécution utilisent la même graine (seed), pour être d'accord sur chaque entité partagée. Chaque groupe produit ses propres métriques de confidentialité et d'utilité et ses propres rapports.
En pratique
- Exécutions sur base de données : comment se déroule une exécution, et ce que la base de données cible doit respecter.
- Lancer une copie de base de données dans le client web
- Lancer une copie de base de données avec le client Python