Données tabulaires simples
Ce document décrit la méthode simple d’anonymisation de données tabulaires développée par Octopize. Cette approche permet d’anonymiser des données individuelles, où chaque ligne correspond à un individu indépendant. La méthode a été publiée ouvertement1 dans la littérature scientifique et est également protégée par un brevet2. Sa singularité réside dans son approche centrée sur l’individu, garantissant une forte préservation de l’utilité tout en assurant une confidentialité prouvée.
Champ d’application
Cette méthode d’anonymisation s’applique dans les conditions suivantes :
Données en entrée : nécessite des données pseudonymisées, c’est-à-dire qu’à ce stade il n’y a plus d’identifiants directs dans le jeu de données.
Types de données supportés :
- Variables continues (entier ou décimal)
- Variables catégorielles textuelles (quel que soit le nombre de catégories)
- Variables catégorielles numériques
- Variables booléennes
- Dates
- Données manquantes (le schéma original des valeurs manquantes est préservé)
Scalabilité : peut traiter efficacement des jeux de données allant de quelques dizaines à plusieurs milliards d’enregistrements.
Les grands volumes sont traités via une approche batch-parallélisée, assurant des temps de calcul rapides.
Résultat
Les avatars générés présentent les propriétés suivantes par rapport aux données originales :
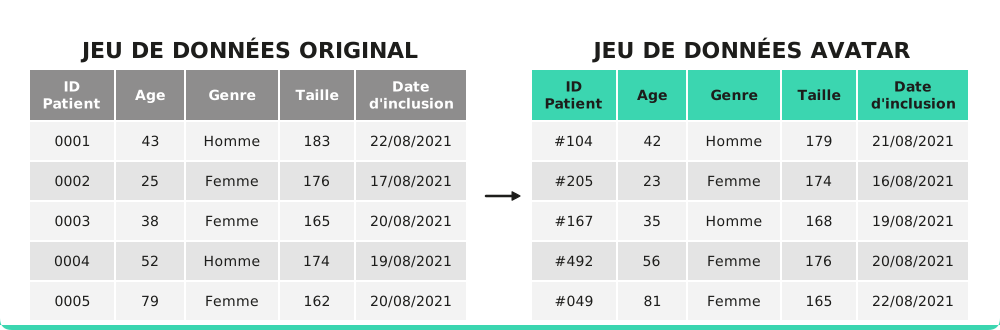
- Même structure : même nombre de variables, mêmes encodages et noms de variables.
- Même granularité : même nombre d’enregistrements (correspondance 1 pour 1).
- Agrégats similaires : les moyennes, sommes, médianes, etc., sont similaires pour toutes les variables.
- Liens similaires : les corrélations entre variables sont conservées.
- Propriétés de clustering similaires : l’information multivariée au sein du jeu de données est préservée.
Algorithme central
Approche globale
En résumé, le cœur de la méthode Avatar suit trois étapes majeures.
- Entrée : les données entrantes sont un jeu de données tabulaire pseudonymisé.
- Cœur de la méthode Avatar :
- a. Les observations individuelles sont projetées dans un espace multidimensionnel complet.
- b. À partir des premières dimensions, on calcule les distances entre toutes les observations sensibles pour trouver les plus proches voisins, définissant une zone locale.
- c. Pour chaque individu, un avatar unique est généré de façon pseudo-stochastique dans sa zone locale. Les paramètres , et d’autres pilotent l’aléatoire et le contenu informationnel des simulations.
- d. Les propriétés du jeu d’avatars sont évaluées via des métriques de ré-identification et de conservation du signal.
- Sortie : les avatars sont reconvertis de leurs coordonnées dans l’espace projeté vers les valeurs dans l’espace original correspondant au jeu initial. Les observations synthétiques (lignes) sont mélangées afin de supprimer le lien entre individus originaux et avatars.
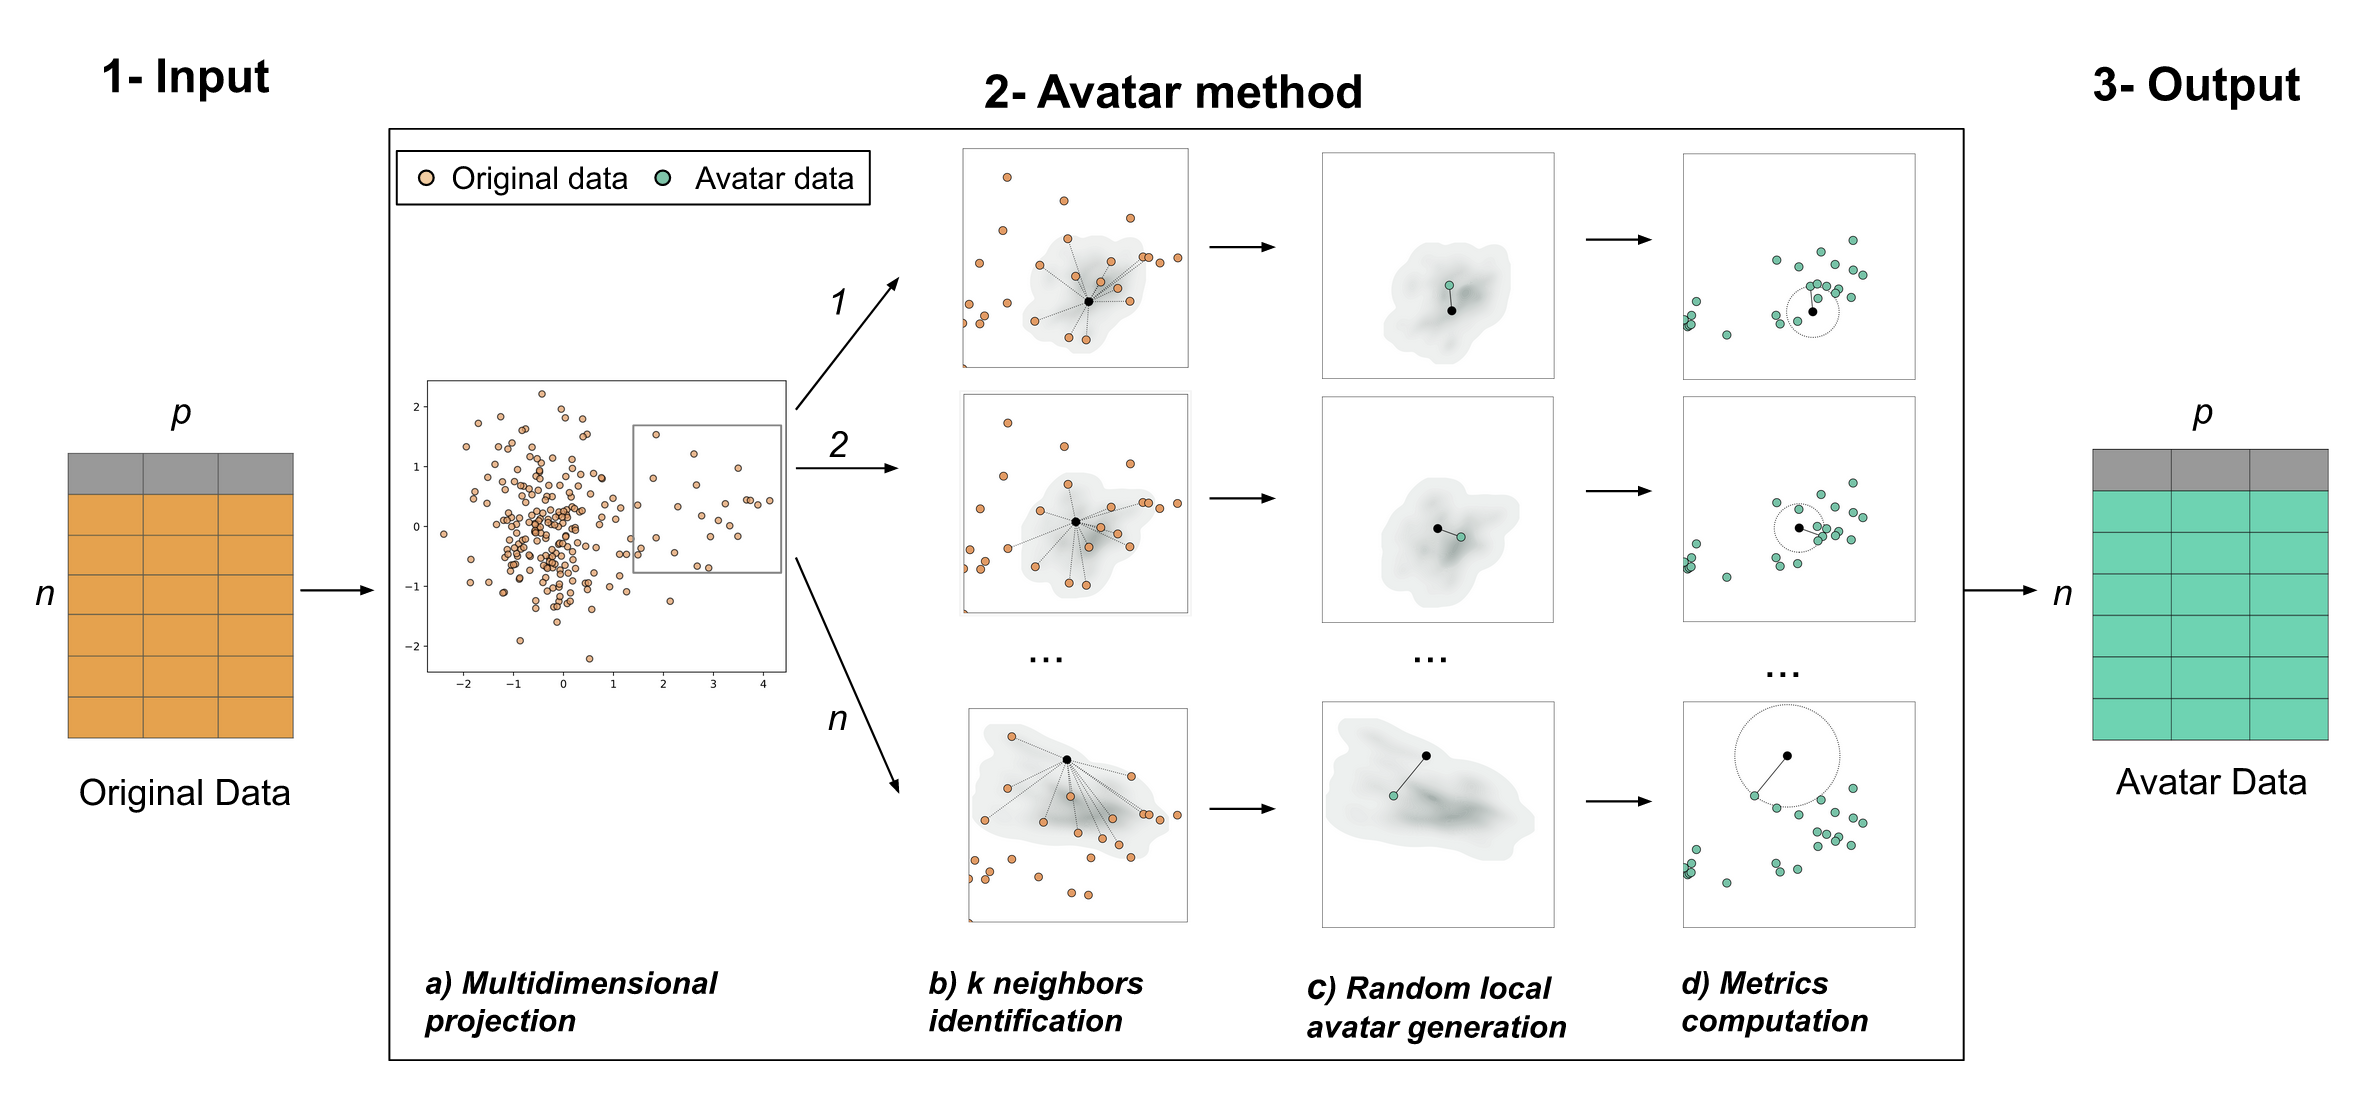
Figure 1 : la méthode Avatar utilise une modélisation locale pour générer de manière stochastique un individu synthétique, appelé avatar.
Légende : (1) Données sensibles pseudonymisées originales. (2) L’anonymisation consiste en quatre étapes : (2a) projection des individus dans un espace multidimensionnel ;
(2b) calcul des distances pour trouver les k plus proches voisins (ici ) dans un espace réduit ; (2c) génération pseudo-aléatoire d’un individu synthétique dans le sous-espace défini par les voisins ; (2d) évaluation des métriques de confidentialité et d’utilité. (3) Jeu de données synthétique en sortie.
Génération des coordonnées synthétiques
À l’étape 2c, un avatar est généré pour un individu au barycentre pondéré de ses voisins.
Le poids de chaque voisin est défini par :
Avec :
- : distance entre l’individu et son voisin k,
- : poids aléatoire suivant une loi exponentielle,
- : contribution, où est la valeur à l’indice du vecteur mélangé aléatoirement.
Les poids sont ensuite normalisés pour être compris entre 0 et 1 :
L’avatar est généré au centre pondéré des plus proches voisins :
où :
- sont les nouvelles coordonnées de l’avatar de l’individu,
- les poids de ses voisins,
- les coordonnées des voisins.
Les coordonnées de l’avatar sont ensuite transformées inversement dans l’espace original, via l’opération inverse de l’analyse factorielle utilisée en étape 2a.
Singularité de l’approche
Cette méthode d’anonymisation se distingue par son design transparent et explicable, offrant un contrôle complet sur le processus et son évaluation. En générant les données dans un espace local projeté, l’approche garantit la création d’individus synthétiques plausibles préservant les relations multivariées.
De plus, l’introduction d’un aléatoire contrôlé garantit le caractère irréversible de l’anonymisation. L’approche centrée sur l’individu améliore également l’évaluation du risque résiduel, offrant une analyse plus complète de la protection des données générées.
Citer cette page
Si vous utilisez la méthode avatar dans vos travaux, merci de citer :
Guillaudeux, M., Rousseau, O., Petot, J. et al. Patient-centric synthetic data generation, no reason to risk re-identification in biomedical data analysis. npj Digit. Med. 6, 37 (2023). https://doi.org/10.1038/s41746-023-00771-5