Base de données relationnelle
Les données relationnelles désignent plusieurs tables avec des relations hiérarchiques ou longitudinales entre elles. Cette structure est appelée données multi-table.
Une simple anonymisation tabulaire appliquée indépendamment à chaque table serait insuffisante. En effet, la confidentialité et l’utilité dépendent non seulement des tables individuelles mais aussi des relations entre elles.
Pour gérer cette structure de données de manière simple et efficace, nous avons développé un cadre dédié.
Ce cadre garantit la protection et la préservation des relations inter-tables tout en maintenant l’utilité des données et la confidentialité au sein de chaque table.
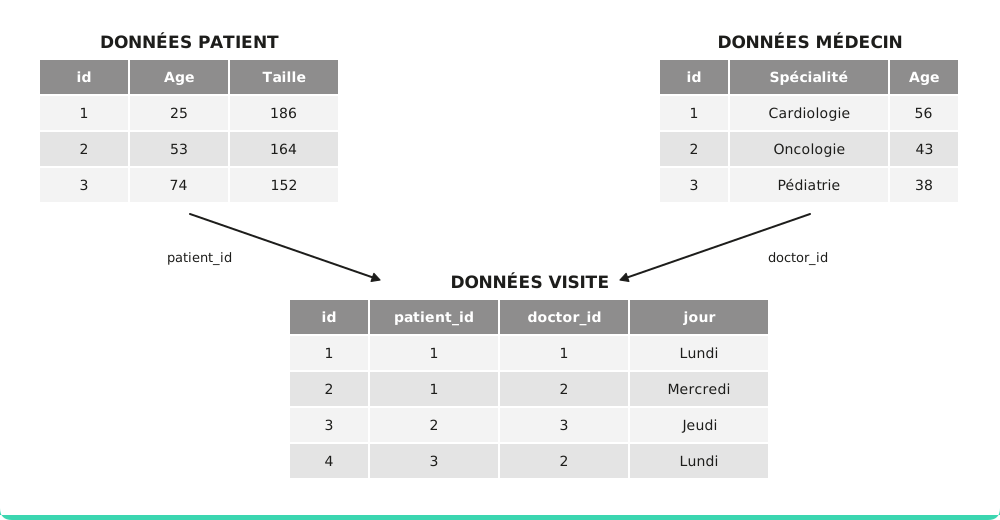
Exemple de base structurée avec 3 tables. Le risque de confidentialité inter-tables est illustré par le patient 1 étant le seul à avoir 2 visites. L’utilité inter-tables est illustrée par le fait que les femmes ont en moyenne plus de visites que les hommes.
Champ d’application
La méthode d’anonymisation multi-table partage le même champ d’application que l’approche tabulaire simple, c’est-à-dire qu’elle supporte les types de données suivants :
Types de données supportés :
- Variables continues (entier ou décimal)
- Variables catégorielles textuelles (quel que soit le nombre de catégories)
- Variables catégorielles numériques
- Valeurs booléennes
- Dates
- Données manquantes (le schéma original des valeurs manquantes sera préservé)
Scalabilité :
Cette méthode peut traiter efficacement des jeux de données allant de quelques dizaines à plusieurs milliards d’enregistrements. Les gros volumes sont gérés via une approche batch parallélisée, garantissant des temps de calcul rapides.
Cependant, la modélisation des relations entre tables nécessite que des contraintes supplémentaires soient respectées pour assurer à la fois la protection de la confidentialité et la cohérence structurelle.
Chaque table doit contenir au moins une variable identifiante, appelée clé primaire, qui détient une valeur unique par ligne.
Les relations entre tables sont établies via des clés étrangères, qui sont des variables identifiantes faisant référence à la clé primaire d’une autre table. Contrairement aux clés primaires, les clés étrangères n’ont pas besoin d’être uniques dans leur table, permettant à plusieurs lignes de pointer vers la même entité référencée.
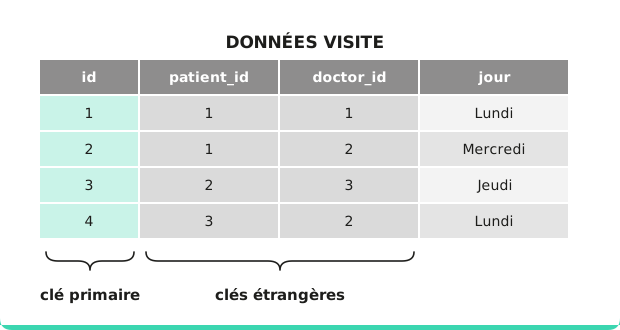
Exemple de clé primaire et clé étrangère dans une table enfant
Résultat produit
Comme pour l’anonymisation tabulaire simple, les avatars issus de l’anonymisation multi-table possèdent les propriétés suivantes par rapport aux données originales :
- Même structure : Même nombre de variables avec le même encodage et les mêmes noms de variables.
- Même granularité : Même nombre d’enregistrements (correspondance 1-à-1).
- Agrégats similaires : Moyennes, sommes, médianes, etc., similaires sur toutes les variables.
- Liens similaires : Corrélations similaires entre variables.
- Propriétés de clustering similaires : L’information multivariée à l’intérieur du jeu de données est préservée.
Mais aussi :
- Relations inter-tables similaires : L’information multivariée entre tables est préservée.
Algorithme principal
Définitions
On appelle table parente la table dont la clé primaire est référencée dans une autre table.
On appelle table enfant la table ayant une clé étrangère référant une autre table.
Enfin, une table individuelle est une table où chaque ligne correspond à un individu unique. Dans notre exemple, PATIENT_DATA et DOCTOR_DATA sont des tables individuelles.
Un lien est défini entre une table parente avec une clé primaire et une table enfant avec une clé étrangère qui y réfère.
Algorithme
L’anonymisation d’une base multi-table est effectuée sur chaque lien entre tables, en partant du haut vers le bas.
La table la plus haute est celle qui n’a pas de table parente.
Pour chaque lien, le processus s’effectue en trois étapes principales :
- Enrichissement
- Avatarisation
- Appariement
Pour chaque lien entre tables (par exemple entre PATIENT_DATA et VISIT_DATA) :
1. Enrichissement
Diffuser l’information de la table parente dans la table enfant. La jointure est basée sur la clé primaire de la table parente et la clé étrangère de la table enfant référant la parente.
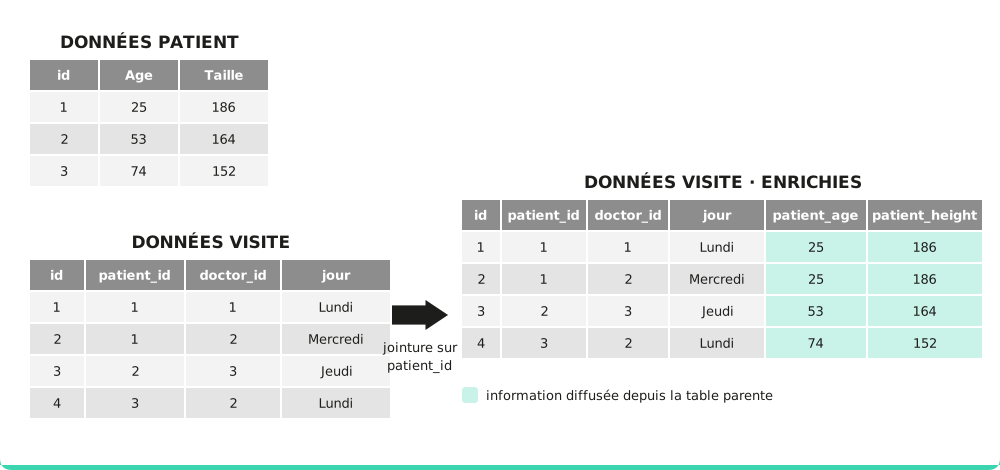
Illustration de l’étape d’enrichissement réalisant une diffusion d’information de haut en bas.
2. Avatarisation
- Anonymiser la table parente en utilisant l’anonymisation tabulaire décrite ici.
- Anonymiser la table enfant enrichie, également par anonymisation tabulaire.
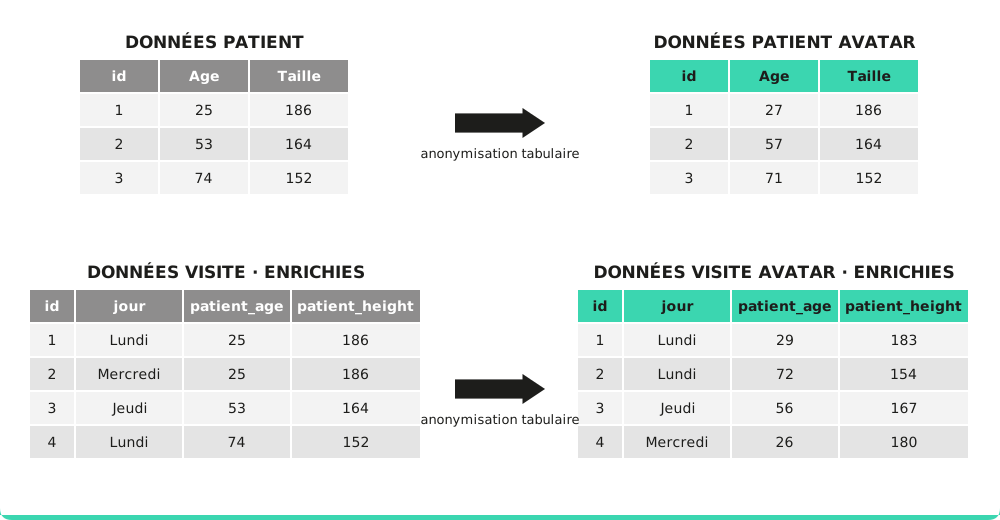
Illustration de l’étape d’avatarisation tabulaire pour la table parente et la table enfant enrichie.
3. Appariement
Selon la nature, la sensibilité et le volume des données, nous avons développé trois méthodes pour réaliser l’appariement.
- Appariement par distance minimale
- Les informations communes de la table parente avatarisée et de la table enfant enrichie avatarisée sont transformées en coordonnées via une méthode en composantes principales (ACP ou Analyse Factorielle des Données Mixtes).
- Les distances sont calculées entre les coordonnées des deux tables.
- Chaque enregistrement de la table enfant enrichie avatarisée est associé à l’enregistrement le plus proche de la table parente avatarisée pour recréer la clé étrangère parentale dans la table enfant avatarisée.
- Les colonnes diffusées de la table parente vers la table enfant sont supprimées pour créer la table enfant finale avatarisée.
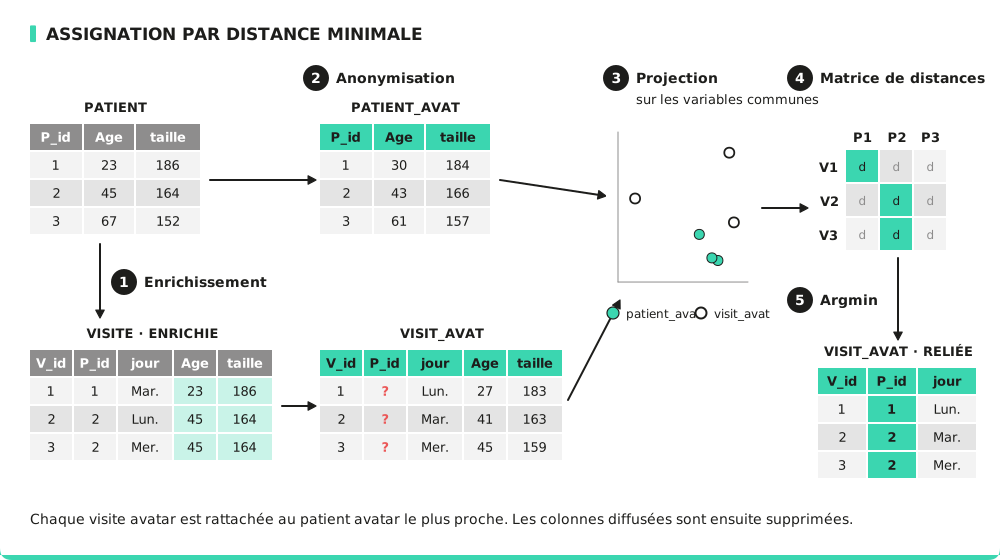
Illustration de la méthode d’appariement par distance minimale pour recréer un lien plausible entre parent et enfant.
- Appariement par somme linéaire
- Le nombre d’événements enfant par identifiant parent est avatarisé dans la table parente.
- Les lignes de la table parente sont dupliquées selon ce compte avatarisé (nécessaire pour que l’algorithme s’applique à des jeux de données de même forme).
- Les informations communes des tables parente dupliquée et enfant enrichie avatarisées sont transformées en coordonnées via une méthode en composantes principales.
- Les distances sont calculées entre ces coordonnées.
- Un algorithme d’optimisation (assignation linéaire) est appliqué pour recréer le lien entre tables : chaque ligne de la table parente dupliquée est associée à un enregistrement avatarisé enfant en minimisant la somme totale des distances.
- Les colonnes diffusées de la table parente vers la table enfant sont supprimées pour créer la table enfant finale avatarisée.
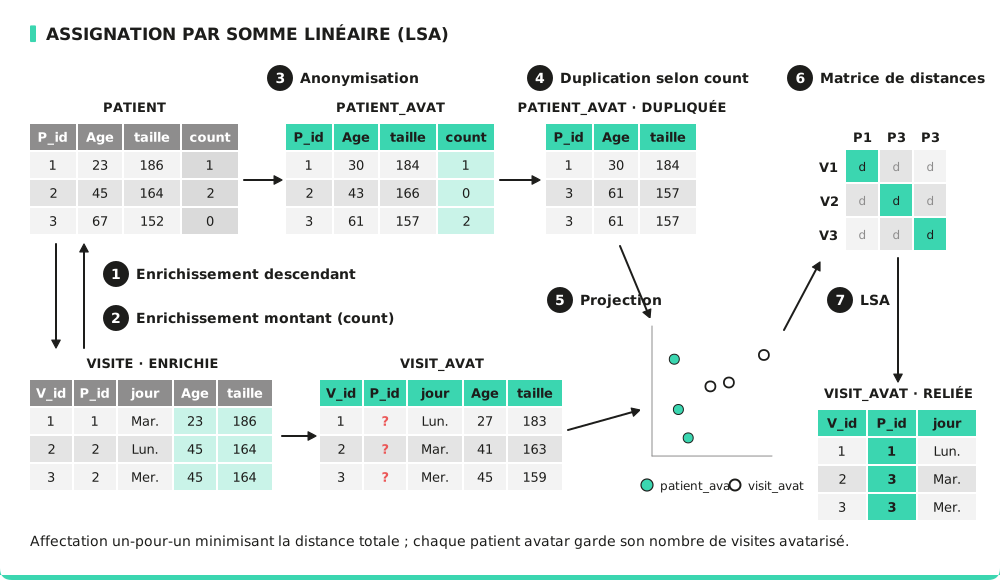
Illustration de la méthode d’appariement par somme linéaire.
- Appariement par ordre original
- Cette méthode consiste à conserver exactement le même lien que dans l’original, donc les visites avatarisées d’un individu spécifique seront réassignées à son avatar.
Choisir l’une des trois méthodes d’appariement pour générer des liens plausibles entre tables parentes et enfants.
Avantages et inconvénients des différentes méthodes d’appariement
Appariement par distance minimale
C’est la méthode qui garantit le niveau de confidentialité le plus élevé.
Elle est plus rapide que la méthode LSA, mais préserve moins bien les distributions agrégées entre tables, par exemple le nombre de visites par patient.
Appariement par somme linéaire
Cette méthode offre le meilleur compromis entre confidentialité et préservation de l’utilité.
Elle préserve bien les distributions agrégées entre tables tout en protégeant les événements rares (par exemple un patient avec un nombre anormal de visites).
Elle est aussi la plus lente des trois, car elle utilise un algorithme d’optimisation.
Ordre original (sensible)
Cette méthode est rapide et garantit une parfaite préservation des distributions agrégées entre tables.
Cependant, elle offre les garanties de confidentialité les plus faibles.
Calcul des métriques
Puisque la confidentialité et l'utilité dépendent non seulement des tables mais aussi des relations entre elles, nous calculons plusieurs approches pour évaluer le risque à la fois au niveau des tables et des liens.
Métriques de confidentialité
Pour évaluer la confidentialité, nous utilisons les métriques définies ici. Compte tenu des caractéristiques du contexte multi-table, nous avons identifié trois scénarios d'évaluation distincts :
Table au niveau individuel
Pour chaque table individuelle (patient et doctor dans notre exemple), nous évaluons la confidentialité des données à travers différents scénarios :
STANDALONE
Ce scénario évalue la protection des individus d'une table en calculant directement les métriques de confidentialité sur la table seule.
ENRICHIE VERS LE HAUT
Ce scénario évalue la protection des individus dans une table en considérant les informations de sa table enfant. La table individuelle est enrichie avec les informations agrégées de sa table enfant, et les métriques de confidentialité sont calculées sur cette table enrichie.
La table patient peut montrer un risque de réidentification faible. Cependant, si la table visit liée révèle qu'un patient spécifique a un nombre unique de visites, ce nombre peut compromettre le patient. En agrégeant les informations de visites dans la table patient, nous pouvons évaluer si cette information supplémentaire compromet la confidentialité du patient.
PROPAGATION D'INFORMATION VERS LE BAS
Ce scénario évalue la protection des individus dans une table en considérant les informations de sa table parente. La table individuelle est enrichie avec les informations de sa table parente, et les métriques de confidentialité sont calculées sur cette table enrichie.
Considérez une table hospital parente de la table doctor. Si un hôpital spécifique n'a qu'un seul médecin spécialisé dans un domaine rare, l'information de spécialité propagée de la table hospital vers la table doctor pourrait rendre ce médecin unique. En propageant cette information, nous pouvons évaluer si la relation compromet la confidentialité du médecin.
Une table pouvant avoir à la fois des parents et des enfants, plusieurs scénarios sont considérés.
Voici une représentation des tables pour lesquelles les métriques de confidentialité sont calculées selon les différents scénarios :
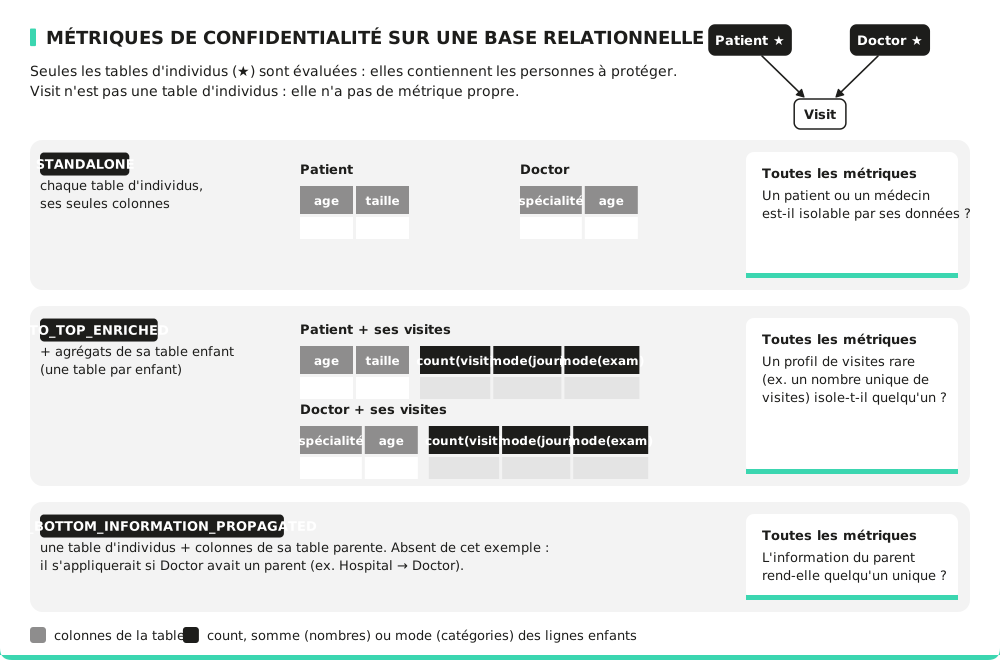
Métriques de signal
Pour évaluer le signal (utilité), nous utilisons les métriques définies ici.
Pour évaluer le niveau d’utilité de l’avatarisation sur les tables et leurs relations, nous définissons 3 types de scénarios :
Chaque table
STANDALONE : Les métriques de signal sont calculées pour chaque table individuellement, sans considérer les relations avec les autres tables.
Table parente
ENRICHIE VERS LE HAUT : Ce scénario évalue la force de la relation entre une table parente et sa table enfant. La table parente est enrichie avec des informations agrégées de sa table enfant, et la distance de Hellinger est calculée. Ce processus est répété pour chaque enfant de la table parente.
Table enfant
PROPAGATION D'INFORMATION VERS LE BAS : Ce scénario évalue le lien entre une table enfant et sa table parente. La table enfant est enrichie avec les informations diffusées depuis sa table parente, et le ratio de différence de corrélation est calculé pour évaluer l'utilité du lien.
Comme une table peut avoir des parents et des enfants, plusieurs scénarios sont considérés.
Dans notre cas d'étude, voici les tables pour lesquelles les métriques de signal sont calculées selon les différents scénarios :
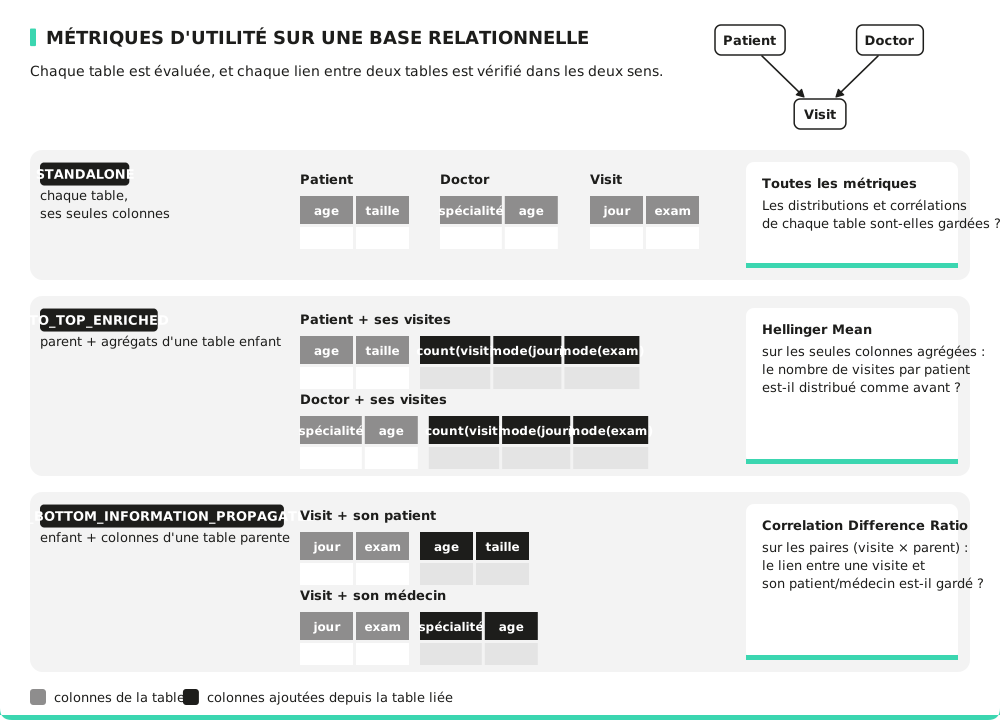
Interprétation des métriques
Lors de l'évaluation des métriques de confidentialité et de signal dans un contexte multi-table, vous devez regarder au-delà des tables et aussi considérer les relations entre elles. Nous fournissons un ensemble de métriques pour vous assurer d'avoir le contexte complet nécessaire pour juger la qualité de l'anonymisation.
Bien que l'analyse multi-table puisse être complexe, les directives et l'exemple de tableau récapitulatif suivants vous aideront à interpréter vos résultats et à affiner vos paramètres d'avatarisation pour équilibrer confidentialité et utilité.
Le tableau récapitulatif met en évidence les méta-métriques pour une vérification rapide de l'ensemble de vos données. Pour une analyse plus approfondie des indicateurs spécifiques, vous pouvez consulter les résultats détaillés des métriques. Cela vous permet d'identifier les risques potentiels en un coup d'œil.
Les lignes représentent la table au niveau individuel (les individus que vous protégez), tandis que les colonnes représentent toutes les tables qui pourraient potentiellement divulguer des informations sur ces individus.
| Nom de la table | Patient | Doctor | Visit |
|---|---|---|---|
| Patient | STANDALONE(Patient) | TO_TOP_ENRICHED(Patient, Visit) | |
| Doctor | STANDALONE(Doctor) | TO_TOP_ENRICHED(Doctor, Visit) |
| Nom de la table | Patient | Doctor | Visit |
|---|---|---|---|
| Patient | 90% | 60% | |
| Doctor | 85% | 90% |
Dans le tableau ci-dessus, la table patient a un score de confidentialité de 90%. Cependant, lorsqu'elle est analysée avec la table visit, le score chute à 60%.
Améliorer vos résultats
Si vous remarquez une baisse significative de la confidentialité en raison des relations entre les tables, envisagez les ajustements suivants :
-
Changer la méthode d'appariement : Essayez une méthode d'assignation différente, telle que l'appariement par somme linéaire ou l'appariement par distance minimale, pour voir si elle équilibre mieux la confidentialité et l'utilité.
-
Augmenter K : Augmentez le paramètre k à la source du risque (dans ce cas, la table
visit).