Séries temporelles
Les données de séries temporelles sont un type spécifique de jeu de données où une variable est enregistrée à plusieurs reprises sur une période donnée. Exemples : mesures de capteurs, données financières, signaux médicaux tels que les électrocardiogrammes (ECG).
Contrairement aux données tabulaires classiques, les séries temporelles contiennent plusieurs enregistrements (lignes) par individu. L’essentiel de l’information réside souvent dans l’évolution des valeurs au fil du temps plutôt que dans une observation isolée. Par exemple, une augmentation soudaine de la tension artérielle n’a de sens que si elle est analysée en relation avec les mesures précédentes.
Un jeu de données comporte typiquement plusieurs variables temporelles, chacune avec des fréquences d’enregistrement et durées différentes. Par exemple, un véhicule collecte des données télémétriques provenant de plusieurs capteurs, chacun avec une fréquence d’échantillonnage propre.
Si une variable temporelle comporte peu de mesures par individu (par exemple moins de cinq), il est préférable de la structurer en données tabulaires classiques en assignant chaque mesure à une colonne distincte, ou d’utiliser l’approche multi-table. La méthode décrite ici s’applique aux séries temporelles avec un nombre important de pas de temps.
Pour être pleinement informatives, les séries temporelles sont souvent accompagnées de données tabulaires statiques (ex. âge, sexe du patient, caractéristiques du dispositif). Ce jeu complémentaire est appelé données standard et peut être anonymisé conjointement aux variables temporelles.
Les avatars peuvent gérer plusieurs variables de séries temporelles, même avec des longueurs (temps entre premier et dernier enregistrement) et fréquences (nombre d’observations par seconde) différentes. Cependant, si les différences de longueur et fréquence sont trop importantes, les variables doivent être stockées dans des jeux de données séparés.
Notez aussi que l’approche Séries Temporelles peut être intégrée dans une anonymisation multi-table (données standard comme table parente, séries temporelles comme table enfant).
Champ d’application
Pour garantir une anonymisation efficace, les séries temporelles doivent respecter les conditions suivantes :
-
Données numériques uniquement : les variables temporelles doivent être numériques (les données catégorielles ne sont pas supportées).
-
Pas de valeurs manquantes : les séries temporelles ne doivent pas contenir de valeurs manquantes, bien que celles-ci soient autorisées dans les données standard associées.
-
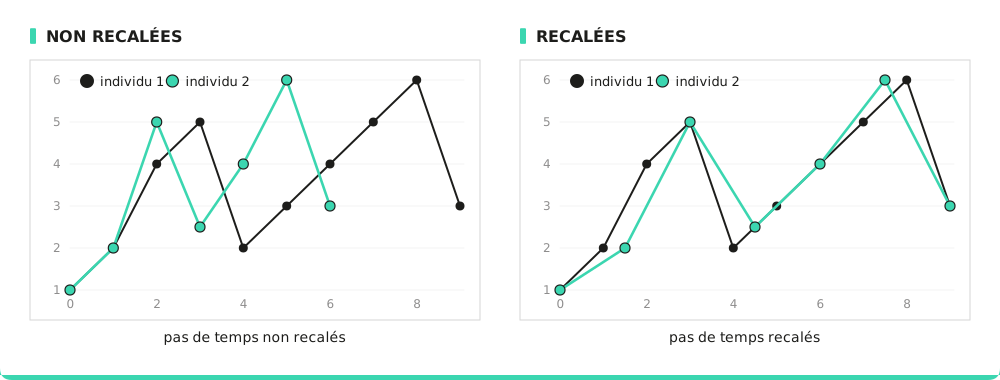
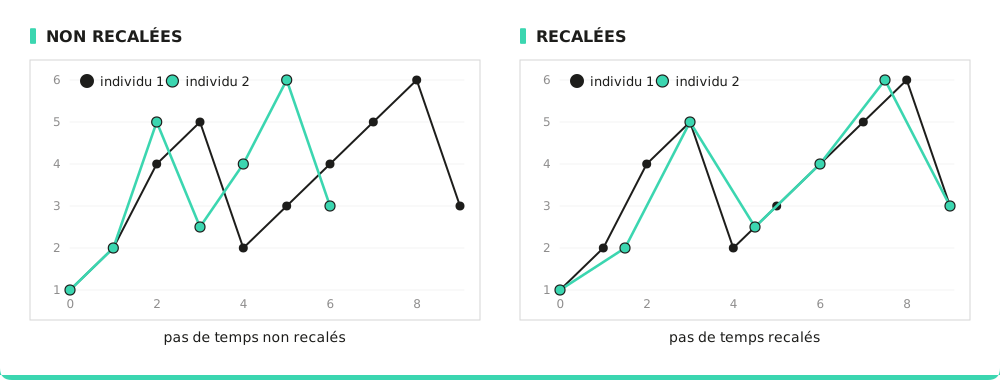
Séries temporelles enregistrées (registered) : dans un même jeu, toutes les séries doivent être enregistrées, c’est-à-dire :
- Chaque variable a une valeur à chaque pas de temps.
- Les pas de temps sont identiques pour toutes les variables.
- Les séries temporelles à un pas de temps donné sont comparables.
Un outil est fourni pour effectuer cet enregistrement avant anonymisation.
-
Intervalles réguliers : les séries temporelles doivent être uniformément espacées dans le temps (intervalle fixe entre observations). Un outil est également fourni pour cela.
-
Taille du jeu de données : le nombre d’individus doit être au moins égal au produit du nombre de pas de temps par le nombre de variables temporelles.
-
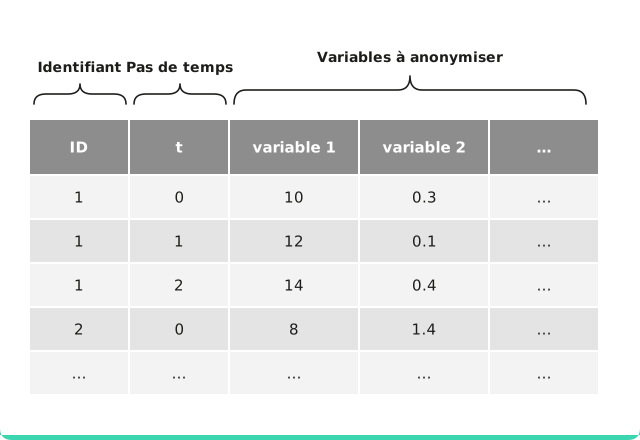
Variables identifiantes obligatoires : les données temporelles doivent contenir :
- Un identifiant individuel (clé primaire, surtout en cas d’usage multi-table).
- Une variable temps
- Les variables à anonymiser
Ce format plat suit une convention standard pour la représentation des séries temporelles.
Scalabilité :
Cette méthode peut traiter efficacement des jeux allant de quelques dizaines à plusieurs milliers de pas de temps pour plusieurs séries. Les gros volumes sont gérés par un traitement batch-parallélisé assurant des temps de calcul rapides.
Particularités des données cycliques
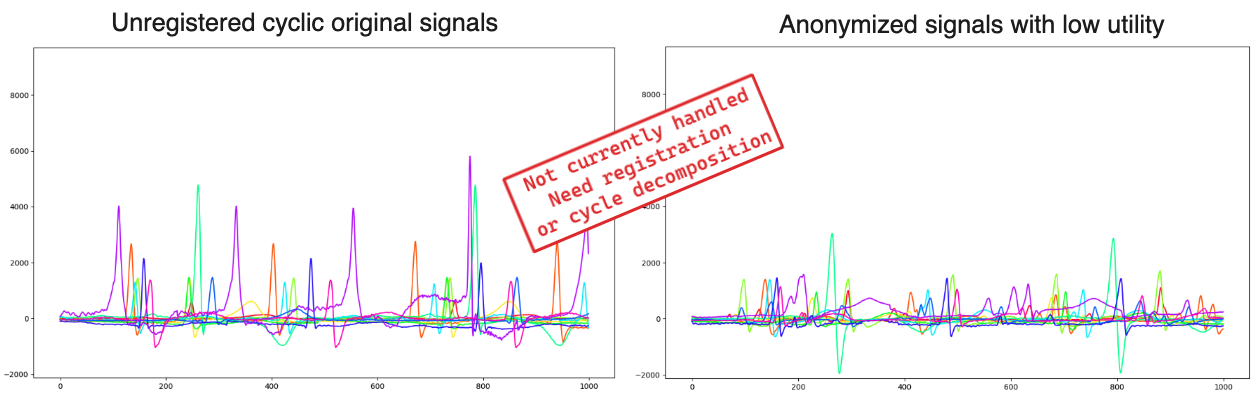
Les données cycliques, où les motifs se répètent périodiquement (ex. signaux ECG), ne sont pas nativement supportées par cette méthode. En effet, des cycles de longueurs différentes entre individus entraînent des séries non enregistrées, dégradant le résultat anonymisé.
Pour anonymiser correctement des données cycliques, il faut d’abord extraire et traiter chaque cycle individuellement, puis reconstruire le signal complet. Si cette étape est impossible, une anonymisation au niveau du cycle est recommandée.
Notre publication scientifique [^1] détaille une approche pour anonymiser les signaux ECG.
Résultat
Les données synthétiques issues de cette méthode présentent les propriétés suivantes :
- Granularité similaire : même nombre de pas de temps qu’après enregistrement (les données peuvent être désenregistrées ensuite via les mêmes outils).
- Schémas temporels similaires : l’information univariée est préservée.
- Clustering de motifs similaire : l’information multivariée est conservée.
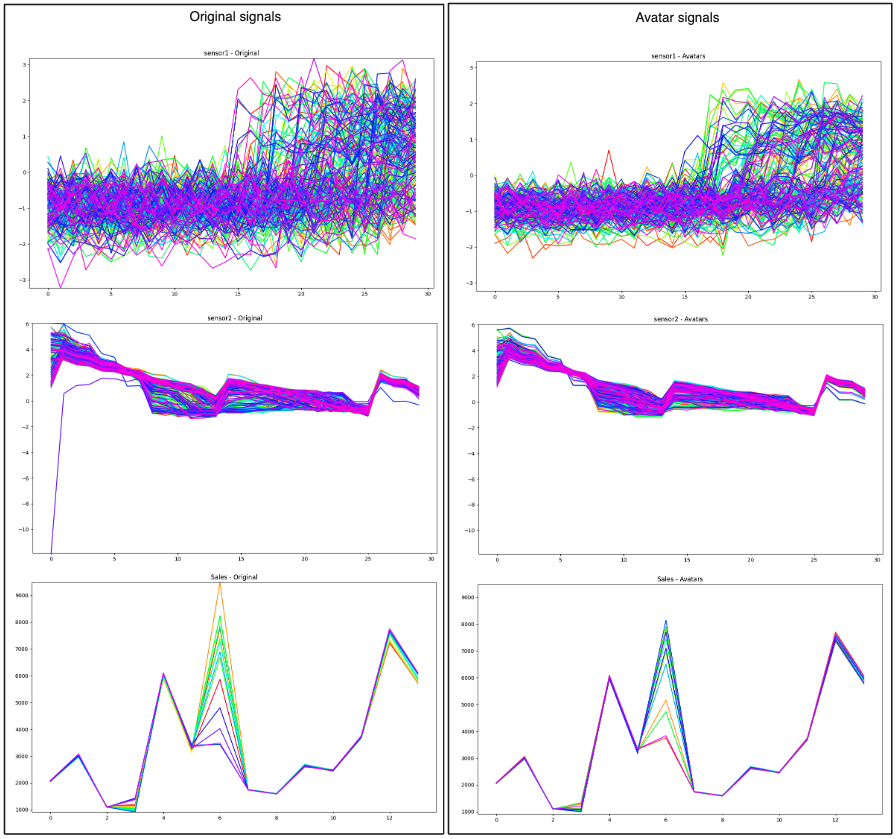
Exemple de données synthétiques en séries temporelles versus données originales
Algorithme central
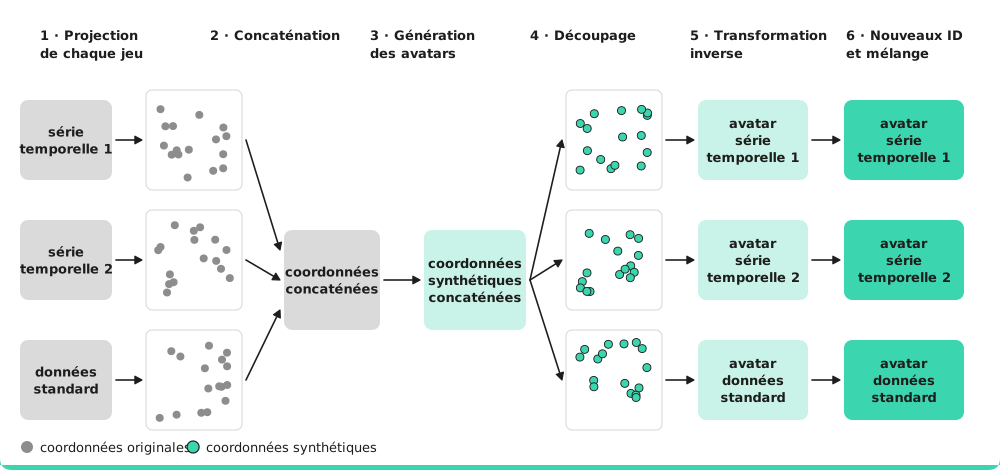
Pour anonymiser les séries temporelles, le processus global est similaire à celui des données tabulaires standard décrit ici, à l’exception de la projection spécifique aux séries temporelles.
-
La première étape consiste à projeter les données de chaque table dans un espace multidimensionnel où chaque ligne représente un individu. Les données standard sont projetées comme dans le cas tabulaire classique, via une méthode en composantes principales (ACP ou Analyse Factorielle de Données Mixtes).
Pour préserver les relations, tendances et autres informations entre mesures temporelles, des méthodes de projection spécifiques (FFT, ACP Fonctionnelle...) sont utilisées pour les séries temporelles. Actuellement, la projection est réalisée via l’Analyse en Composantes Principales Fonctionnelle (ACP Fonctionnelle ou FPCA). -
Une fois chaque jeu projeté dans son espace propre, les données projetées des différents jeux sont concaténées pour obtenir un seul ensemble de coordonnées. Après concaténation, une ligne contient l’information de tous les jeux pour un individu donné.
-
(Optionnel) : En cas de multiples séries temporelles, si l’on souhaite conserver l’information multivariée entre séries, on peut soit projeter toutes les séries avec une FPCA multivariée, soit appliquer une ACP sur les coordonnées concaténées.
-
Après concaténation, des coordonnées synthétiques sont générées comme expliqué ici.
-
Les coordonnées synthétiques sont séparées de façon à regrouper les variables projetées par jeu de données d’origine.
-
La projection est inversée pour que les données synthétiques soient exprimées dans leur forme originale.
-
Enfin, les identifiants individuels sont régénérés et les jeux mélangés.