Closest Rate
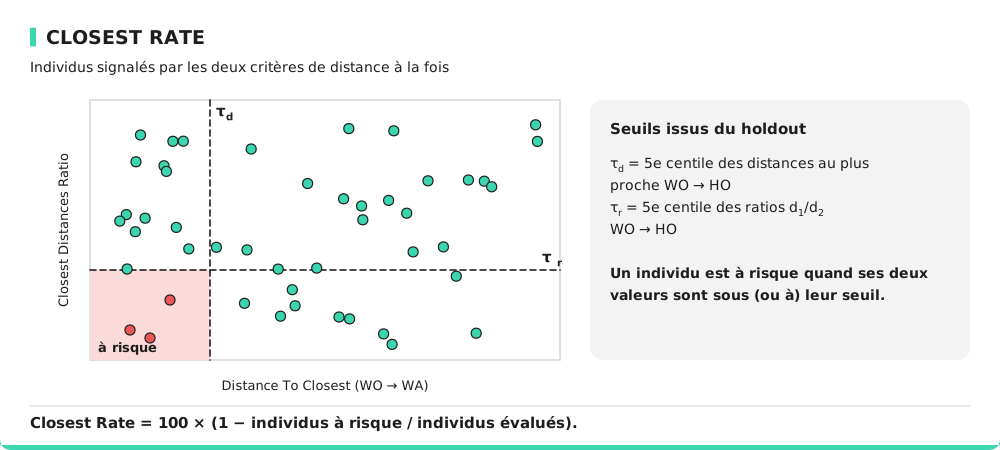
La métrique Closest Rate combine les résultats des métriques Distance To Closest et Closest Distances Ratio afin de déterminer le pourcentage d’individus dont l’avatar le plus similaire n’est pas trop proche, et pour lesquels la paire donnée originale/avatar n’est pas facilement distinguable du reste du jeu de données. Elle fournit une mesure globale de la dissociation entre les données originales et leurs avatars dans le jeu de données synthétiques.
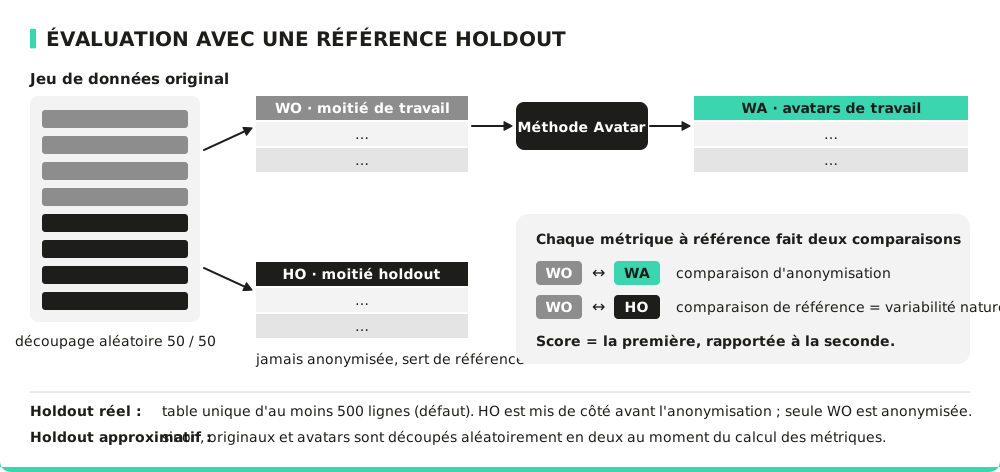
Comme les deux métriques qu’elle combine, le Closest Rate est basé sur une référence : il compare l’anonymisation (WO, la moitié de travail anonymisée, vs ses avatars WA) à la variabilité naturelle des données réelles (WO vs une référence mise de côté HO, la moitié de réserve intacte).
Sur les jeux de données suffisamment grands (par défaut ≥ 500 lignes), un holdout réel est mis de côté avant l’anonymisation ; sur les plus petits, un holdout approximatif est obtenu en divisant aléatoirement les données au moment du calcul des métriques. Voir la section « Évaluation avec une référence de holdout » du rapport d'évaluation technique.
Interprétation du Closest Rate
Le Closest Rate mesure la qualité de séparation des avatars par rapport aux données originales tout en s’assurant que la paire donnée originale/avatar ne soit pas facilement identifiable parmi les autres avatars du jeu. Cette mesure composite reflète à la fois la distance entre un individu et son avatar le plus proche, ainsi que la distinction entre cette paire originale/avatar et le reste des avatars générés.
Considérons un jeu de données avec un Closest Rate de 85%.
Cela signifie que pour 85 % des individus, leur avatar le plus similaire n’est pas trop proche des autres avatars, et leur paire donnée originale/avatar n’est pas facilement identifiable par rapport aux autres points de données.
À l’inverse, un Closest Rate faible peut indiquer qu’une part significative d’individus a des avatars très similaires ou facilement repérables, ce qui augmente le risque de réidentification.
Spécificité de la métrique
Le Closest Rate est particulièrement utile pour fournir une mesure globale de la qualité de l’anonymisation lors de la génération de données synthétiques. En combinant les résultats de la Distance To Closest et du Closest Distances Ratio, cette métrique offre une vue d’ensemble de la séparation entre données originales et avatars, facilitant l’évaluation du risque de réidentification.
Formule
À partir des valeurs de Distance To Closest (, ) et de Closest Distances Ratio (, ), deux seuils sont tirés de la référence holdout, avec par défaut :
Un individu est à risque lorsque ses deux valeurs sont inférieures ou égales à ces seuils :
est le -ième centile (interpolation au point milieu) et le nombre d'individus pour lesquels un ratio est disponible.
Comment améliorer cette métrique ?
Pour améliorer le Closest Rate, il est recommandé d’augmenter la valeur de k, qui représente le nombre de voisins pris en compte lors de la génération des données synthétiques. Une valeur plus élevée de k accroît la séparation entre avatars et données originales, réduisant ainsi le risque que les avatars soient trop proches des données réelles ou facilement confondus avec d’autres avatars dans le jeu de données.