Attaque par inférence d'appartenance (MIA)
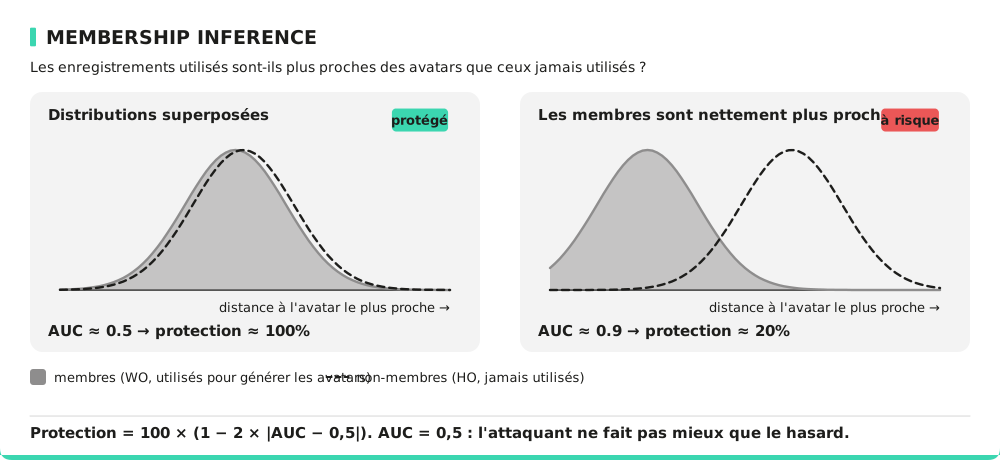
La métrique Membership Inference Attack (MIA) évalue si un attaquant peut déterminer qu'un individu spécifique faisait partie des données d'entraînement utilisées pour générer les avatars. Elle mesure la proximité de cet individu à l'avatar le plus proche, comparée à celle d'individus n'ayant pas fait partie des données d'entraînement.
Contrairement au Hidden Rate, qui repose sur un indicateur binaire (l'avatar le plus proche est-il celui de l'individu ?), la métrique MIA utilise la distribution complète des distances pour détecter des fuites d'appartenance subtiles. Deux jeux de données peuvent avoir le même Hidden Rate tout en présentant des niveaux très différents de fuite réelle d'appartenance.
Inférence d'appartenance dans les données synthétiques
Il ne s’agit pas seulement de savoir si une ligne synthétique correspond à une ligne réelle de manière univoque. Le cœur du problème est de déterminer si un attaquant peut conclure, avec un signal statistique fort, qu’une personne spécifique a bien participé à l’ensemble initial ou au jeu de données utilisé pour générer les données synthétiques.
Le mécanisme technique est généralement lié au surapprentissage ou à la mémorisation d’individus atypiques. Quand un modèle ou un générateur de données synthétiques mémorise trop fidèlement un profil rare, les données produites ou les sorties du modèle conservent une trace statistique reconnaissable de cette personne. En d’autres termes, l’attaque n’exige pas une copie exacte ; une combinaison distinctive de variables peut suffire pour faire ressortir l’individu.
Exemple : jeu de données médicales
- Contexte : un hôpital publie un jeu de données synthétiques issu d’une étude réelle sur un traitement expérimental contre le VIH. L’objectif est de permettre à des chercheurs externes de faire des statistiques sans accéder aux dossiers patients.
- Connaissance de l’attaquant : un voisin sait que Marc s’est rendu régulièrement à l’hôpital en 2025 et connaît quelques faits publics à son sujet (homme, 48 ans, code postal 35000, groupe sanguin O+).
- Attaque : l’attaquant analyse le jeu de données synthétiques et remarque une concentration anormale de profils très spécifiques combinant exactement : homme, 48 ans, code postal 35000, groupe O+, associés à des biomarqueurs très précis.
- Résultat : l’attaquant peut conclure, avec une forte confiance statistique, que Marc faisait partie de la cohorte d’origine. Il infère ainsi un élément de santé extrêmement sensible : Marc est atteint du VIH.
C’est précisément le risque couvert par le critère d’inférence d’appartenance : les données synthétiques ont conservé assez de signal original pour révéler qu’une personne concrète était membre de la base source.
Fonctionnement
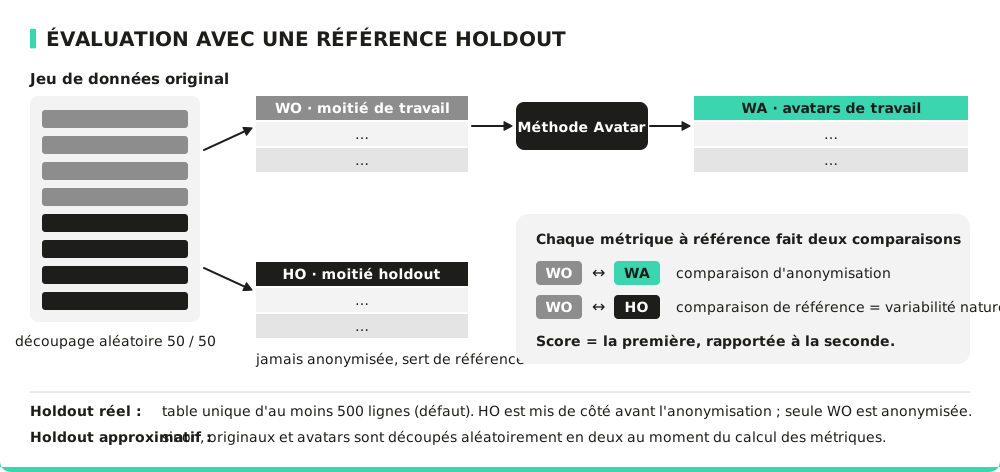
Deux populations sont comparées :
- Membres — les données originales utilisés pour générer les avatars (originaux de travail).
- Non-membres — les données de contrôle (hold-out) qui n'ont pas été utilisés lors de la génération des avatars.
Pour chaque individu, la distance euclidienne à l'avatar le plus proche est calculée. Si les membres sont systématiquement plus proches de leurs avatars que les non-membres, un attaquant peut exploiter cet écart de distance pour inférer l'appartenance.
La force de ce signal est quantifiée par une AUC-ROC (via la statistique U de Mann-Whitney), convertie ensuite en taux de protection :
- AUC = 0.5 (50 %) → taux de protection = 100 % (estimation aléatoire — confidentialité parfaite)
- AUC = 0 ou 1 (0 % ou 100 %) → taux de protection = 0 % (attaque parfaite — aucune confidentialité)
Variantes brute et normalisée
Deux variantes de la métrique sont calculées :
- MIA brute : utilise les distances euclidiennes brutes à l'avatar le plus proche.
- MIA normalisée : divise chaque distance par une distance de référence à la population opposée (les distances des membres divisées par la distance au non-membre le plus proche, et inversement).
La variante normalisée prend en compte la densité locale dans l'espace des variables. Dans les régions peu denses, même des distances importantes peuvent être inhabituellement faibles, tandis que dans les régions denses, de courtes distances peuvent être typiques. La normalisation revient à se demander « cette distance est-elle inhabituelle pour cette région ? » plutôt que « cette distance est-elle grande en termes absolus ? »
Le taux de protection normalisé est généralement plus robuste et doit être privilégié pour l'interprétation.
Interprétation de l'attaque par inférence d'appartenance
Le taux de protection MIA varie de 0 à 100 :
- Un taux de protection proche de 100% signifie que les distributions de distances des membres et des non-membres sont indiscernables — un attaquant ne peut pas exploiter la proximité aux avatars pour inférer l'appartenance. C'est le résultat idéal.
- Un taux de protection proche de 0% signifie qu'il existe un écart de distance net entre les membres et les non-membres, rendant l'inférence d'appartenance trivialement possible.
Cette métrique se rattache au critère d'individualisation : elle mesure si un attaquant peut déterminer qu'un individu spécifique a contribué au jeu d'entraînement.
Spécificité de la métrique
Avantages :
- Détecte si un attaquant peut inférer l'appartenance d'une donnée à un jeu de données synthétique que des métriques plus simples (comme le Hidden Rate) peuvent manquer, en analysant les distributions complètes de distances plutôt qu'un indicateur binaire.
- Repose sur un cadre statistique bien établi (AUC-ROC via la statistique U de Mann-Whitney).
- La variante normalisée prend en compte les variations de densité locale dans l'espace des variables, rendant la métrique robuste sur des données hétérogènes.
Limites :
- Nécessite un jeu de données de contrôle (hold-out), ce qui réduit la quantité de données disponibles pour la génération des avatars.
- Les résultats peuvent varier en fonction de la taille et de la représentativité du jeu de contrôle.
- Sur de très petits jeux de données, la puissance statistique du test sous-jacent peut être limitée.
Formule
Les membres sont les originaux de travail (taille ), les non-membres le holdout (taille ). Chaque enregistrement reçoit sa distance à l'avatar de travail le plus proche :
Avec la somme des rangs des distances des non-membres dans l'échantillon regroupé trié par ordre croissant (les ex æquo reçoivent leur rang moyen), l'AUC est la statistique de Mann-Whitney :
Pour la variante normalisée, chaque distance est divisée par la distance à l'enregistrement le plus proche de la population opposée (sous-échantillon aléatoire de taille ) : , et la même AUC est calculée sur . Les distances sont euclidiennes, calculées dans l'espace projeté de l'anonymisation ( premières composantes).
Comment améliorer cette métrique ?
Pour améliorer le taux de protection MIA, vous pouvez augmenter le paramètre k, qui contrôle le nombre de voisins considérés lors de la génération des avatars. Une valeur plus élevée de k augmente la distance entre les membres et leurs avatars les plus proches, rendant les distributions de distances des membres et des non-membres plus similaires.
Il est également recommandé de s'assurer que le jeu de contrôle est suffisamment grand et représentatif de la population globale, car un jeu de contrôle biaisé ou trop petit peut fausser la métrique.
La métrique MIA nécessite un jeu de données de contrôle (hold-out), un sous-ensemble d'individus qui n'a pas été utilisé lors de la génération des avatars.