Distance To Closest
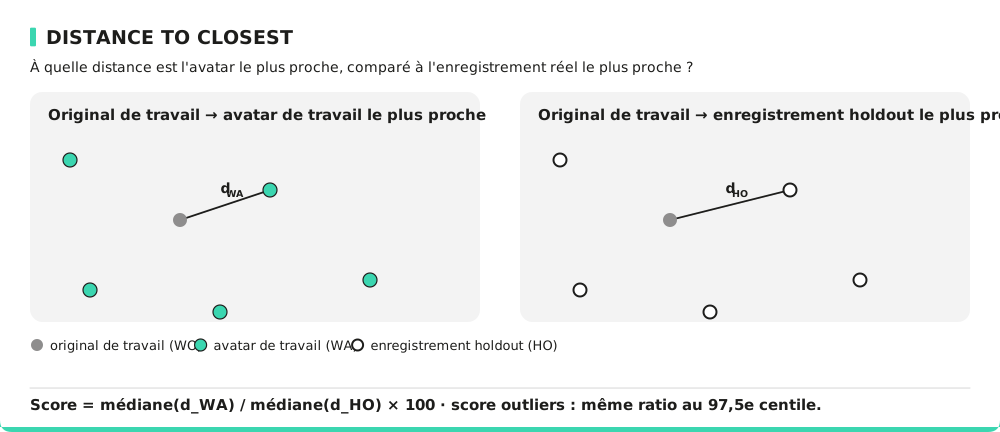
La métrique Distance To Closest calcule la distance euclidienne médiane entre un individu et l’avatar le plus proche dans le jeu de données, sans prendre en compte le lien entre la donnée originale et son avatar.
Cette métrique donne une idée de la proximité entre les données synthétiques et la distribution des données originales, tout en évitant les connexions directes entre individus et avatars.
Pour des raisons d'interprétabilité, la valeur obtenue est comparée à une valeur de référence. Le score final est un rapport entre la valeur de Distance To Closest calculée sur les avatars et celle calculée sur un ensemble de données de référence. Ce score final permet d'évaluer si la proximité des avatars par rapport aux individus originaux est similaire à celle observée dans les données de référence.
L'approche est également appliquée aux outliers du jeu de données, en calculant le Distance To Closest pour les individus ayant grande distance avec le premier voisin (isolés).
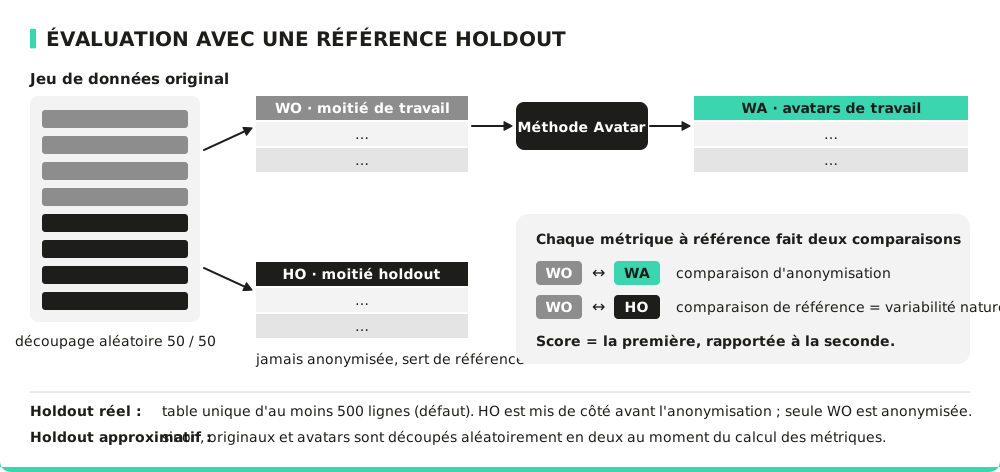
Cette métrique est basée sur une référence : elle compare l’anonymisation (WO vs ses avatars WA) à la variabilité naturelle des données réelles (WO vs une référence mise de côté HO).
- WO — moitié de travail originale : la partie des données originales qui est anonymisée.
- WA — avatars de travail : les avatars générés à partir de WO.
- HO — moitié de réserve originale : un second échantillon de données réelles, laissé intact, utilisé uniquement comme référence.
Sur les jeux de données suffisamment grands (par défaut ≥ 500 lignes), un holdout réel est mis de côté avant l’anonymisation ; sur les plus petits, un holdout approximatif est obtenu en divisant aléatoirement les données au moment du calcul des métriques. Voir la section « Évaluation avec une référence de holdout » du rapport d'évaluation technique.
Stratégie de comparaison (Holdout)
Pour réaliser le score final retourné à l'utilisateur, nous réalisons les étapes suivantes :
- Obtention de la moitié de travail WO et d’une moitié de réserve HO disjointe à partir des données réelles (holdout réel ou approximatif — voir la note ci-dessus).
- Utilisation des avatars de travail WA, générés à partir de WO.
- Calcul de la métrique Distance To Closest sur l’ensemble WO en utilisant WA comme base d’attaque. (pour le médiane et les outliers)
- Calcul de la métrique Distance To Closest sur l’ensemble WO en utilisant HO comme base d’attaque. (pour le médiane et les outliers)
- Calcul du rapport entre les deux performances obtenues.
On obtient ainsi en sortie:
- Le rapport du Distance To Closest médian entre les avatars et les données de référence.
- Le rapport du Distance To Closest des outliers entre les avatars et les données de référence.
Interprétation de la Distance To Closest
La métrique Distance To Closest varie de 0 à l’infini :
- Une valeur faible indique que les avatars sont très proches des données originales, ce qui peut suggérer un risque accru de réidentification.
- Une valeur élevée signifie que les avatars sont éloignés des données originales, ce qui est favorable pour la protection de la vie privée.
La valeur du rapport du Distance To Closest retourné à l'utilisateur s’interprète lui de la manière suivante :
-
une valeur proche de 100 ou supérieur indique que la proximité des avatars vis à vis des données originales est similaire à celle des données de référence, suggérant que le processus de génération des avatars ne permet pas d'identifier de manière fiable des associations entre donnée d'origine et avatar.
-
une valeur très inférieure à 100 signifie que les avatars sont significativement plus proches des données d'origine que ce que l'on observe dans la variabilité naturelle du jeu de données, ce qui suggère un risque accru de réidentification.
Ces deux valeurs peuvent être interprétées de manière similaire pour la médiane comme pour les outliers.
Supposons que la Distance To Closest médiane entre mes données d'origine et mes avatars soit de 1, alors que la distance médiane entre ces mêmes données originales et le jeu de référence soit de 2. La valeur du ratio retourné à l'utilisateur sera donc de 50 %. En d'autres termes, les avatars sont en moyenne deux fois plus proches des données originales que ce que l'on observe dans la variabilité naturelle du jeu de données. Ceci représente un risque accru de réidentification.
Spécificité de la métrique
Cette métrique prend tout son sens lorsqu’elle est utilisée conjointement avec la métrique Closest Distances Ratio.
Un jeu de données est considéré comme à risque lorsque les deux métriques sont faibles :
- Une Distance To Closest faible indique que les avatars sont très proches des données originales.
- Un Closest Distances Ratio faible signifie que les paires individu-avatar sont facilement identifiables, ce qui augmente le risque de réidentification.
Formule
Pour chaque original de travail , la distance à son avatar de travail le plus proche et à son enregistrement holdout le plus proche :
est le 97,5e centile (les individus les plus isolés). Lorsque la valeur de référence vaut 0, le score vaut 100. Les distances sont euclidiennes, calculées dans l'espace projeté de l'anonymisation ( premières composantes).
Comment améliorer cette métrique ?
Le moyen le plus efficace pour améliorer la Distance To Closest est d’augmenter le paramètre k, qui définit le nombre de voisins considérés lors de la génération des données synthétiques. Une valeur plus élevée de k permet de répartir les avatars de manière plus homogène dans le jeu de données, augmentant la distance entre avatars et individus, et réduisant ainsi le risque de liaison directe.