Hidden Rate
La métrique Hidden Rate est spécifique à la méthode Avatar. Elle est conçue pour évaluer un scénario d’attaque par liaison de données basée sur la distance. Cette métrique mesure la perte de lien entre une donnée originale et son avatar dans le contexte d’une méthode où chaque individu génère ses propres données synthétiques. Le Hidden Rate peut également être vu comme un mécanisme de garde-fou permettant de s’assurer qu’aucune faille algorithmique ne compromet le processus de synthétisation, et que le lien entre la donnée d’origine et la donnée synthétique est effectivement perdu.
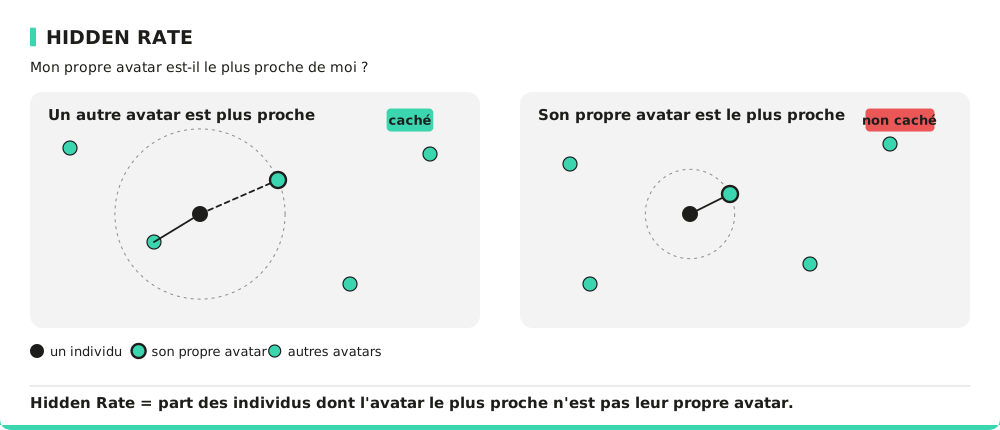
Interprétation du Hidden Rate
Le Hidden Rate peut être interprété ainsi : il représente le pourcentage d’individus dont l’avatar généré n’est pas l’entrée la plus similaire dans le jeu de données.
Si un jeu de données présente un Hidden Rate de 80%, cela signifie que pour 80% des individus, l’avatar généré n’est pas la correspondance la plus proche dans le jeu de données. Cela n’implique cependant pas que les 20% restants soient forcément à risque, car les individus concernés sont choisis au hasard et restent inconnus d’un attaquant.
Spécificité de la métrique
Cette métrique est essentielle pour quantifier l’efficacité de la méthode Avatar à dissocier les données originales des avatars générés. En augmentant le Hidden Rate, il devient plus difficile pour un attaquant d’établir avec certitude un lien entre un individu et son avatar, renforçant ainsi la protection des données personnelles.
Formule
Pour chaque enregistrement original () et son propre avatar , soit le nombre d'autres avatars au moins aussi proches que son propre avatar :
Un individu ne compte contre la métrique que lorsque son propre avatar est, seul, son avatar le plus proche. Les distances sont euclidiennes, calculées dans l'espace projeté de l'anonymisation ( premières composantes).
Comment améliorer cette métrique ?
Pour améliorer le Hidden Rate, il est recommandé d’augmenter le paramètre k, qui correspond au nombre de voisins considérés lors de la génération des données synthétiques. Une valeur plus élevée de k accroît la distance relative entre une donnée originale et son avatar, renforçant ainsi la dissociation et la protection contre les attaques de liaison de données.