Row Direct Match Protection
La métrique Row Direct Match Protection évalue un scénario d’attaque simple en vérifiant le nombre de lignes (enregistrements) uniques identiques entre les données originales et les données synthétiques. L’objectif est de mesurer à quel point les données synthétiques sont distinctes des données originales, afin de garantir que les enregistrements originaux ne puissent pas être directement ré-identifiés. Nous nous concentrons ici sur les enregistrements uniques, car les duplicats peuvent être considérés comme protégés vis à vis du critère d'individualisation.
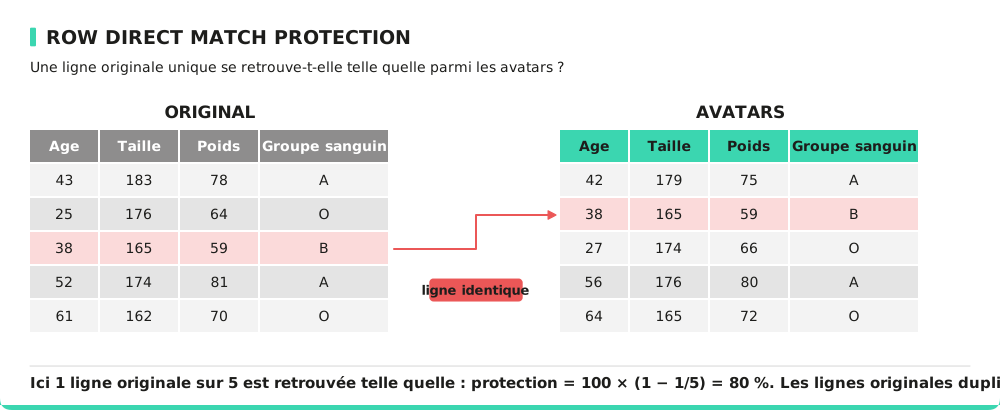
Interprétation de la Row Direct Match Protection
La Row Direct Match Protection est exprimée en pourcentage et indique la proportion d’enregistrements des données originales qui ne sont pas présents tels quels dans les données synthétiques. Un score de 100% signifie qu’aucun enregistrement original ne figure exactement dans les données synthétiques, ce qui est un indicateur positif de protection de la vie privée. À l’inverse, des valeurs faibles indiquent que certains enregistrements originaux sont reproduits dans les données synthétiques, augmentant ainsi le risque de ré-identification.
Imaginons un jeu de données où la Row Direct Match Protection est de 95%. Cela signifie que 95% des enregistrements des données originales ne sont pas reproduits exactement dans les données synthétiques. Autrement dit, seuls 5% des enregistrements sont exactement reproduits, ce qui représente un risque réduit de ré-identification. Un score faible (proche de 0) indiquerait que de nombreuses lignes des données originales sont présentes dans les données synthétiques, compromettant la confidentialité.
Spécificité de la métrique
Cette métrique est particulièrement utile pour vérifier la fiabilité du modèle de génération locale utilisé par la méthode d’anonymisation. Plus le modèle est performant, moins il devrait y avoir de correspondances directes entre données originales et synthétiques. Par ailleurs, cette métrique est plus facile à améliorer pour des jeux de données avec un grand nombre de colonnes, car la probabilité de reproduire une ligne entière est alors réduite.
Formule
Soit les lignes originales qui n'apparaissent qu'une seule fois dans les données originales (les lignes dupliquées se protègent mutuellement et sont écartées), et l'ensemble des lignes avatar distinctes :
Une correspondance exige l'égalité sur toutes les colonnes. est le nombre total de lignes originales.
Comment améliorer cette métrique ?
Pour améliorer la Row Direct Match Protection, il est recommandé d’augmenter le paramètre k, qui correspond au nombre de voisins pris en compte lors de la génération des données synthétiques. Une valeur plus élevée de k augmente l’espace de modélisation locale pour chaque point synthétique, augmentant ainsi la probabilité de générer des données synthétiques différentes des données existantes.