Column Direct Match Protection
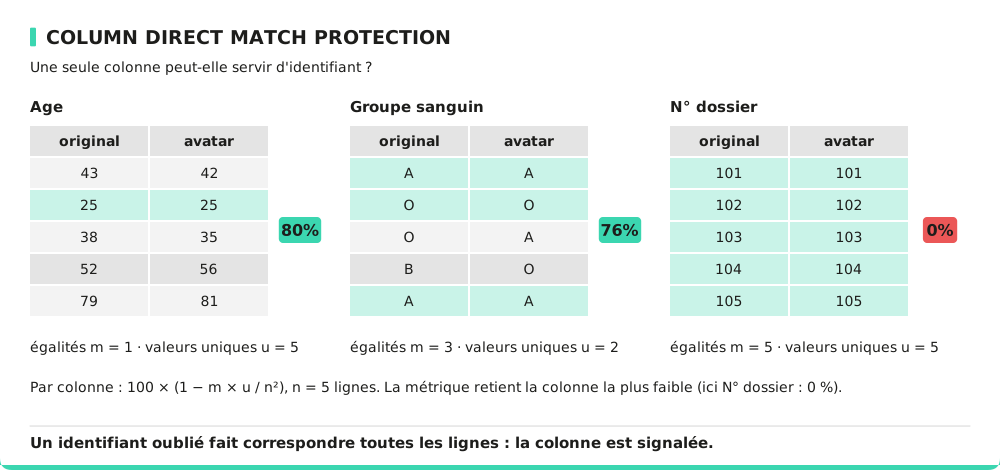
La métrique Column Direct Match Protection évalue un scénario d’attaque simple, où l’objectif est de vérifier si une seule colonne du jeu de données permet une liaison directe entre un individu et son avatar. Elle mesure la capacité de chaque colonne à protéger contre la ré-identification en déterminant si la colonne la plus révélatrice peut isoler des individus et leurs avatars.
La métrique s'accompagne de la liste des colonnes les plus réidentifiantes, classées par ordre décroissant de risque de ré-identification.
Interprétation de la Column Direct Match Protection
La métrique renvoie le pourcentage d’individus dont les données ne peuvent pas être directement ré-identifiées à partir de la colonne la plus révélatrice du jeu de données. Un pourcentage élevé indique que cette colonne ne permet pas de ré-identifier les individus, tandis qu’une valeur proche de 0 suggère que une ou plusieurs colonnes contiennent des informations suffisamment spécifiques pour permettre la ré-identification, comme un identifiant unique oublié.
Imaginons un jeu de données où la Column Direct Match Protection est de 10 %.
Cela signifie que seulement 10 % des individus ne peuvent pas être ré-identifiés directement à partir de la colonne la plus révélatrice. Un score aussi bas pourrait indiquer qu’un identifiant personnel a été oublié lors du processus d’anonymisation, permettant ainsi la ré-identification de certains individus.
Spécificité de la métrique
Cette métrique est particulièrement utile lorsqu’il s’agit de décider de fixer certaines valeurs pendant le processus d’anonymisation. Elle permet d’évaluer l’impact de cette décision sur la protection de la vie privée et de vérifier si certaines variables pourraient compromettre l’anonymisation. Il est essentiel de s’assurer que les colonnes ne contiennent pas de valeurs quasi-identifiantes ou d’identifiants directs pouvant servir à la ré-identification.
Formule
Pour chaque colonne , avec la valeur originale et la valeur avatar à la même position de ligne :
La pondération par fait que les égalités ne pèsent lourd que pour les colonnes à nombreuses valeurs distinctes, comme les identifiants. Les colonnes dont est sous la cible sont listées avec le résultat.
Comment améliorer cette métrique ?
Pour améliorer la Column Direct Match Protection, il est recommandé de s’assurer qu’aucun identifiant ou valeur quasi-identifiante ne subsiste dans le jeu de données anonymisé. Il est également important d’inclure toutes les variables susceptibles d’être utilisées pour identifier directement les individus dans le processus d’anonymisation. En éliminant ou modifiant ces variables, vous renforcez la protection contre la ré-identification.